Pandas
파이썬의 외부 라이브러리 중 데이터 처리를 위해 가장 흔히 사용되는 Pandas 라이브러리에 대하여 살펴봅니다.
- 1. Pandas란?
- 2. Pandas의 개발 이유
- 3. Pandas의 대표적인 데이터 구조
- 1. 사전 작업
- 2. Series
- 3. DataFrame
- 4. Index
- 5. 기타 주요 기능
1. Pandas란?
- Pandas : Panel Data System과 Python Data Analysis에서 따옴
- 데이터 분석을 위해 널리 사용되는 파이썬 라이브러리 패키지
- R의 데이터프레임(Dataframe)과 유사한 형태의 DataFrame 객체가 핵심
- 엑셀과 유사한 2차원 데이터 구조로 되어있어 데이터 전처리 및 가공 용이
- 구글, 페이스북 및 데이터를 분석하는 주요 회사의 데이터 과학자는 거의 대부분이 Pandas를 이용 중
2. Pandas의 개발 이유
- 개발자: 월스트릿의 투자운용회사(헤지펀드) AQR에 근무중이던 웨스 맥키니
- 개발 이유: 회사에서 사용하는 데이터 핸들링 툴이 마음에 들지 않음
- 계기
- 2008년 동료가 파이썬으로 간단한 알고리즘을 작성하는 것을 보고 파이썬에 입문
- 파이썬의 SciPy를 접한 후 상용 통계도구를 대체하는 오픈소스 도구가 많음을 발견
- 스탠포드 대학 조나단 테일러 통계학 교수의 오픈소스 패키지에서 관련 모듈 발견
- 오픈소스를 참고하여 R의 DataFrame 객체를 파이썬으로 이식하는 작업 도전
- 도전 1개월 만에 Pandas 초기버전 출시(2008년 초)
- 개발자가 회사에서 사용하던 데이터 분석 도구에서 원했던 기능
- 자동적, 명시적으로 축의 이름에 따라 데이터를 정렬할 수 있는 자료구조
- 잘못 정렬된 데이터에 의한 일반적인 오류 예방
- 다양한 소스에서 가져온 다양한 방식으로 색인된 데이터를 다루는 기능
- 통합된 시계열 데이터 처리 기능
- 시계열 데이터와 비 시계열 데이터를 함께 다룰 수 있는 통합 자료구조
- 산술 연산과 한 축의 모든 값을 더하는 등의 데이터 축약연산은 축의 이름 같은 메타데이터로 전달 가능해야 함
- 누락된 데이터를 유연하게 처리할 수 있는 기능
- SQL 같은 일반 데이터베이스처럼 데이터를 합치고 관계연산을 수행하는 기능
3. Pandas의 대표적인 데이터 구조
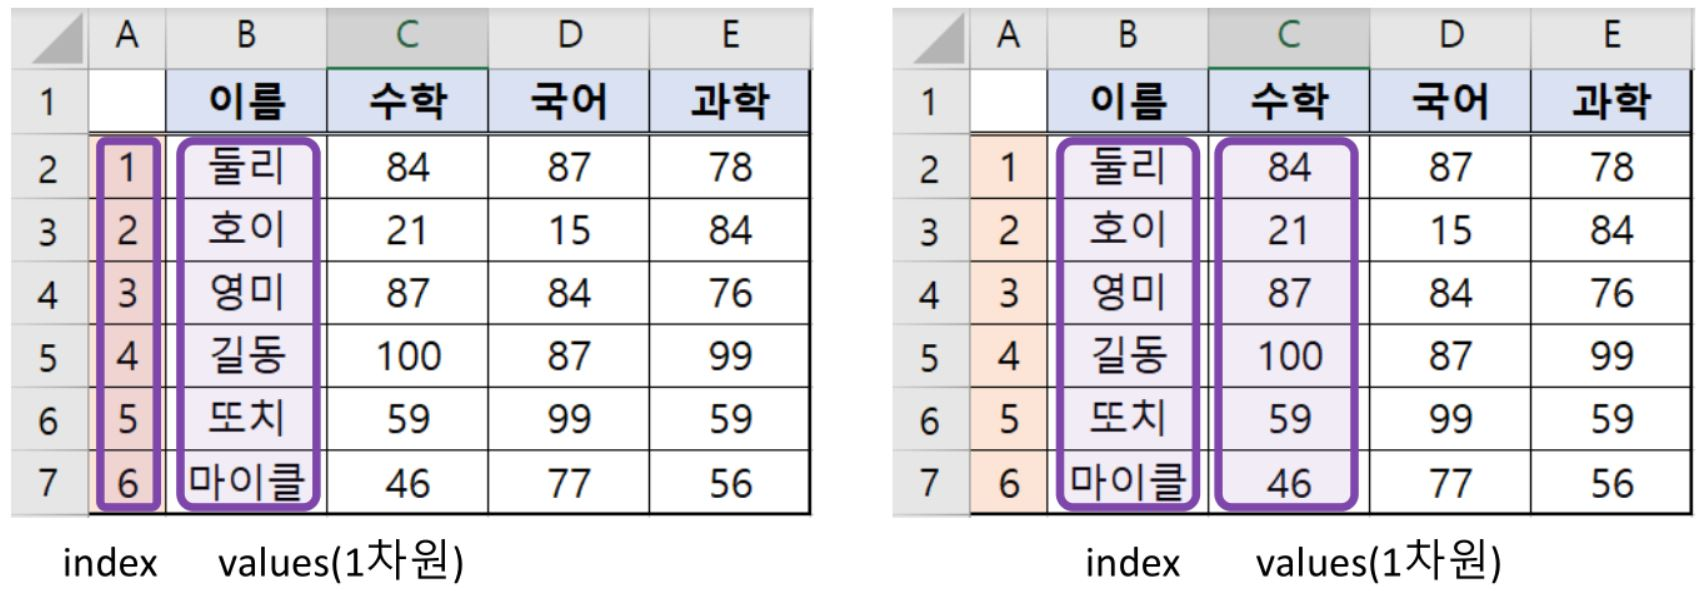
- Series
- 일련의 객체를 담을 수 있는 1차원 배열 같은 자료구조
- 어떤 NumPy 자료형이라도 담을 수 있음
- 배열의 데이터에 연관된 이름을 가진 색인(Index)을 보유
- DataFrame
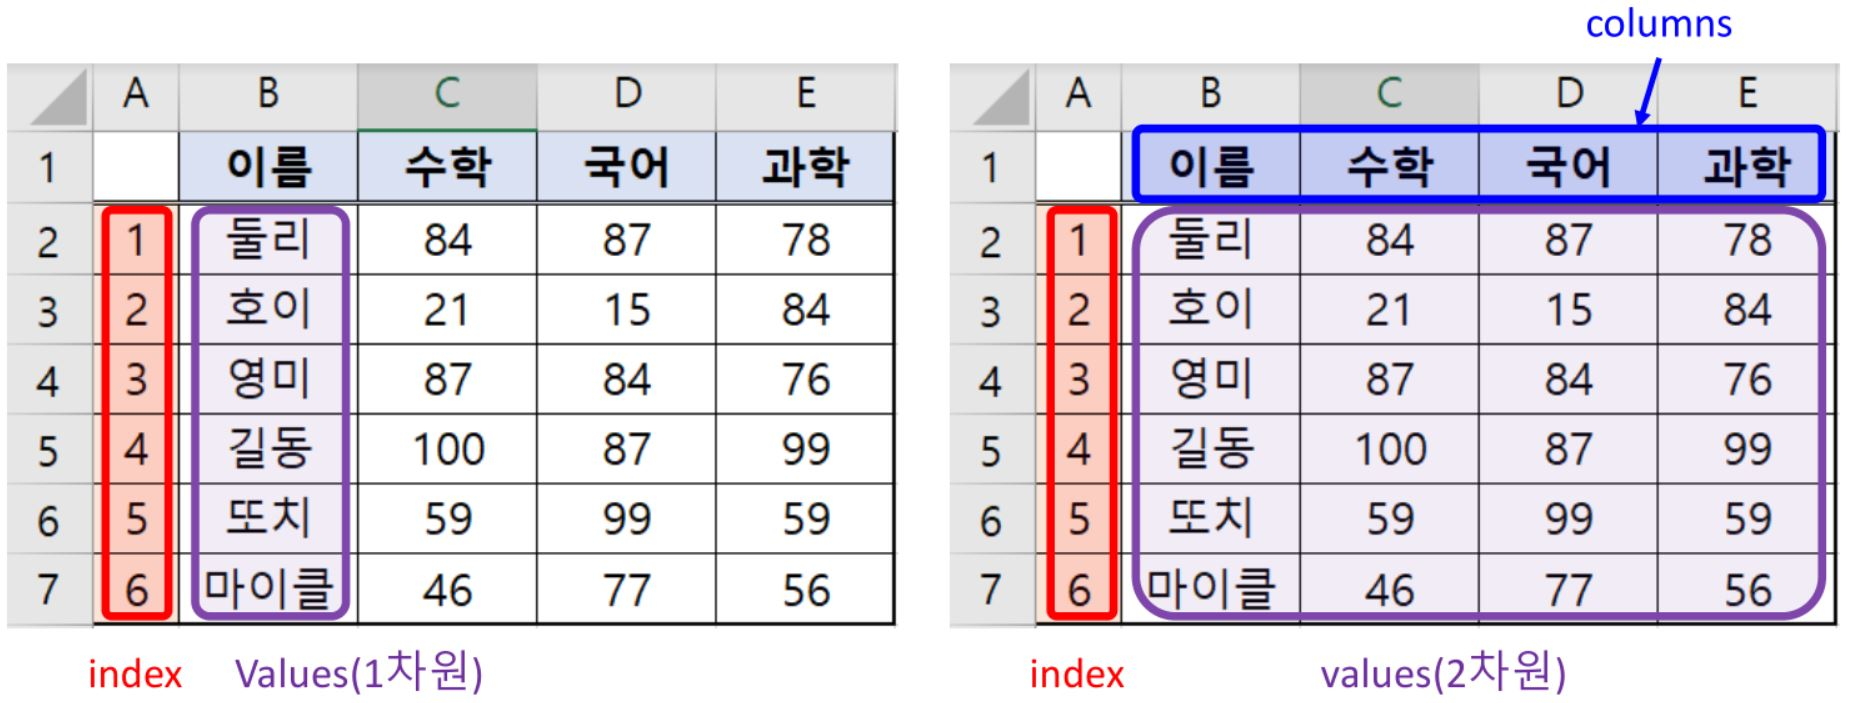
- 표 같은 스프레드시트 형식의 자료구조
- 여러 개의 칼럼을 가지며 각 칼럼은 서로 다른 종류의 값을 담을 수 있음
- Row나 Column에 대하여 색인(Index)을 보유
- Index
- 표 형식의 데이터에서 각 Row와 Column에 대한 이름과 다른 메타데이터(축의 이름)를 저장하는 객체
- DataFrame이나 Series 객체에서 사용됨
- Pandas에서는
- DataFrame과 Series만 알면(특히 DataFrame) 대부분의 애플리케이션에서 사용하기 쉽고 탄탄한 기반을 제공할 수 있음
- 다른 자료구조도 있긴 있지만 위의 두 가지가 가장 중요함
- DataFrame은 색인의 모양이 같은 Series 객체를 담고 있는 (파이썬 기본 자료형인)딕셔너리라고 생각하면 편함

1. 사전 작업
- 라이브러리 설치
pip install pandas
- 모듈 임포트
import numpy as np
import pandas as pd
from pandas import Series, DataFrame    # 코드 취향에 따라 결정
2. Series
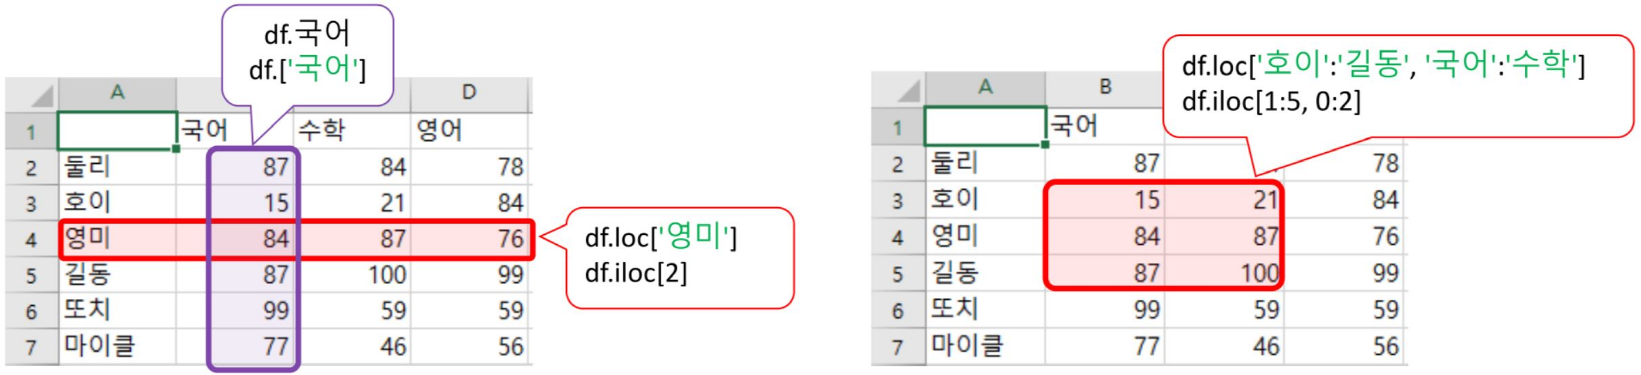
- Series 객체의 문자열 표현: 왼쪽에 색인, 오른쪽에 해당 색인의 값
- Series의 배열과 색인 객체는 각각 values와 index 속성으로 얻을 수 있음
obj = Series([4, 7, -5, 3]) objobj.valuesobj.index -
각각의 데이터를 지칭하는 색인을 지정해서 Series 객체를 생성할 때
obj2 = Series([4, 7, -5, 3], index=['d', 'b', 'a', 'c']) obj2print(obj2.index) print('----------------------------') print(obj2['a']) print('----------------------------')obj2['d'] = 6 print(obj2[['c', 'a', 'd']]) -
불리언 배열을 사용해서 값을 걸러내거나 산술 곱셈을 수행하거나 또는 수학 함수를 적용하는 등 NumPy 배열 연산을 수행해도 색인-값은 유지됨
obj2[obj2 > 0]obj2 * 2np.exp(obj2) -
Series는 고정길이의 정렬된 딕셔너리라고 생각하면 이해하기 쉬움
'b' in obj2'e' in obj2 - 딕셔너리 객체로부터 Series 객체 생성하기
- 딕셔너리 객체만으로 Series 객체를 생성하면 Series 객체의 색인은 딕셔너리의 키 값이 순서대로 들어감
  sdata = {'Ohio': 35000, 'Texas': 71000, 'Oregon': 16000, 'Utah': 5000}

  obj3 = pd.Series(sdata)
  obj3
states = ['California', 'Ohio', 'Oregon', 'Texas'] obj4 = pd.Series(sdata, index=states) obj4 -
누락된 데이터 찾기
pd.isnull(obj4)pd.notnull(obj4)obj4.isnull() -
서로 다르게 색인된 데이터에 대하여 산술 연산 수행하기
print(obj3) print('----------------------------') print(obj4) print('----------------------------') print(obj3 + obj4) -
Name 속성 사용하기
obj4.name = 'population' obj4.index.name = 'state' obj4print(obj) print('----------------------------') obj.index = ['Bob', 'Steve', 'Jeff', 'Ryan'] print(obj)obj.index[0] = ['Bob2']- Pandas Index 객체는 불변(Immutable) 속성이므로 Pandas Series나 DataFrame의 index 객체는 생성된 후 개별 요소를 직접 변경할 수 없음
- 인덱스 값을 변경하고 싶다면, 전체 인덱스를 새로 할당하거나(obj.index = […]), rename 메서드를 사용해야 함
3. DataFrame
-
같은 길이의 리스트에 담긴 딕셔너리를 이용하거나 NumPy 배열을 이용하여 DataFrame 데이터를 생성할 수 있음
data = {'state': ['Ohio', 'Ohio', 'Ohio', 'Nevada', 'Nevada', 'Nevada'], 'year': [2000, 2001, 2002, 2001, 2002, 2003], 'pop': [1.5, 1.7, 3.6, 2.4, 2.9, 3.2]} frame = pd.DataFrame(data) framepd.DataFrame(data, columns=['year', 'state', 'pop'])frame2 = pd.DataFrame(data, columns=['year', 'state', 'pop', 'debt'], index=['one', 'two', 'three', 'four', 'five', 'six']) frame2frame2.columnsframe2['state']frame2.yearframe2.loc['three'] -
Column에는 값을 대입할 수 있음
frame2['debt'] = 16.5 frame2frame2['debt'] = np.arange(6.) frame2 - 리스트나 배열을 Column에 대입할 때
- 대입하려는 값의 길이가 DataFrame의 크기와 같아야 함
- Series를 대입할 경우, DataFrame의 색인에 따라 값이 대입됨
- 없는 색인에는 값이 대입되지 않음
val = pd.Series([-1.2, -1.5, -1.7], index=['two', 'four', 'five']) print(val) print('-------------------------') frame2['debt'] = val frame2 -
없는 Column을 대입하면 새로운 Column이 생성됨
  frame2['eastern'] = frame2.state == 'Ohio'
  frame2
del frame2['eastern'] frame2.columnsframe2 - 중첩된 딕셔너리를 이용해서 데이터를 생성할 때
-
바깥쪽의 딕셔너리의 키 값이 Column이 되고 안에 있는 키는 Row가 됨
  pop = {'Nevada': {2001: 2.4, 2002: 2.9},
      'Ohio': {2000: 1.5, 2001: 1.7, 2002: 3.6}}
frame3 = pd.DataFrame(pop) frame3frame3.T - 안쪽의 딕셔너리의 값은 키 값별로 조합되어 결과의 색인이 됨
-
색인을 직접 지정할 경우, 지정된 색인으로 DataFrame을 생성함
pd.DataFrame(pop, index=[2001, 2002, 2003])
-
-
Series 객체를 담고 있는 딕셔너리 데이터도 동일하게 처리됨
  pdata = {'Ohio': frame3['Ohio'][:-1],
          'Nevada': frame3['Nevada'][:2]}
  pd.DataFrame(pdata)
-
-
DataFrame 생성 시 Index와 Column의 이름을 지정할 수 있음
frame3.index.name = 'year' frame3.columns.name = 'state' frame3 - values 속성은 DataFrame에 저장된 데이터를 2차원 배열로 반환함(Series와 유사)
-
DataFrame의 Column에 서로 다른 dType이 있다면 모든 Column을 수행하기 위해 그 Column 배열의 dType이 선택됨
frame3.valuesframe2.values
-
4. Index
-
Index(색인) 객체 생성
  obj = pd.Series(range(3), index=['a', 'b', 'c'])
  obj
index = obj.index indexindex[1:] -
색인 객체는 변경할 수 없음 → 색인 객체는 자료구조 사이에서 안전하게 공유할 수 있음
index[1] = 'd'labels = pd.Index(np.arange(3)) labelsobj2 = pd.Series([1.5, -2.5, 0], index=labels) obj2obj2.index is labelsframe3frame3.columns'Ohio' in frame3.columns2003 in frame3.indexdup_labels = pd.Index(['foo', 'foo', 'bar', 'bar']) dup_labels
5. 기타 주요 기능
5.1 재색인
-
색인 객체는 변경할 수 없으나 통째로 재색인(Reindexing)할 수는 있음
  obj = pd.Series([4.5, 7.2, -5.3, 3.6], index=['d', 'b', 'a', 'c'])
  obj
obj2 = obj.reindex(['a', 'b', 'c', 'd', 'e']) obj2 - Method 옵션 사용하기
- 시계열 데이터와 같은 순차적인 데이터를 재색인하고자 할 때, 값을 보간하거나 채워넣어야 할 경우 Method 옵션을 사용하여 해결 가능
- 재색인 기능의 Method 옵션
- ffill 또는 pad : 앞의 값으로 채워 넣기
- bfill 또는 backfill : 뒤의 값으로 채워 넣기
obj3 = pd.Series(['blue', 'purple', 'yellow'], index=[0, 2, 4]) obj3obj3.reindex(range(6), method='bfill') -
DataFrame에서 색인(Row), Column 또는 둘 다 재색인 가능
  frame = pd.DataFrame(np.arange(9).reshape((3, 3)),
                      index=['a', 'c', 'd'],
                      columns=['Ohio', 'Texas', 'California'])
  frame
frame2 = frame.reindex(['a', 'b', 'c', 'd']) frame2states = ['Texas', 'Utah', 'California'] frame.reindex(columns=states)
5.2 하나의 Row 또는 Column 삭제하기
- Series에서 Row 삭제
  obj = pd.Series(np.arange(5.), index=['a', 'b', 'c', 'd', 'e'])
  obj
new_obj = obj.drop('c') new_objobjobj.drop(['d', 'c'])obj -
DataFrame에서 Row / Column 삭제
data = pd.DataFrame(np.arange(16).reshape((4, 4)), index=['Ohio', 'Colorado', 'Utah', 'New York'], columns=['one', 'two', 'three', 'four']) datadata.drop(['Colorado', 'Ohio'])data.drop('two', axis=1)data.drop(['two', 'four'], axis='columns')obj -
삭제 결과를 데이터에 즉시 반영하기
  obj.drop('c', inplace=True)
  obj
5.3 색인하기, 선택하기, 거르기
-
기본적인 색인 이용하기
obj = pd.Series(np.arange(4.), index=['a', 'b', 'c', 'd']) objprint(obj['b']) print('----------------------') print(obj[1]) print('----------------------') print(obj[2:4]) print('----------------------') print(obj[['b', 'a', 'd']]) print('----------------------') print(obj[[1, 3]]) print('----------------------') print(obj[obj < 2]) -
라벨명으로 슬라이싱 가능하며 이 때는 시작점과 끝점을 포함한다는 것이 파이썬의 기본 슬라이싱과 다름
  print(obj['b':'c'])
  print('----------------------')
  obj['b':'c'] = 5
  obj
data = pd.DataFrame(np.arange(16).reshape((4, 4)), index=['Ohio', 'Colorado', 'Utah', 'New York'], columns=['one', 'two', 'three', 'four']) dataprint(data['two']) print('----------------------') print(data[['three', 'one']])data[:2]data[data['three'] > 5]data < 5data[data < 5] = 0 data - 색인의 위치정보(loc / iloc) 이용하기
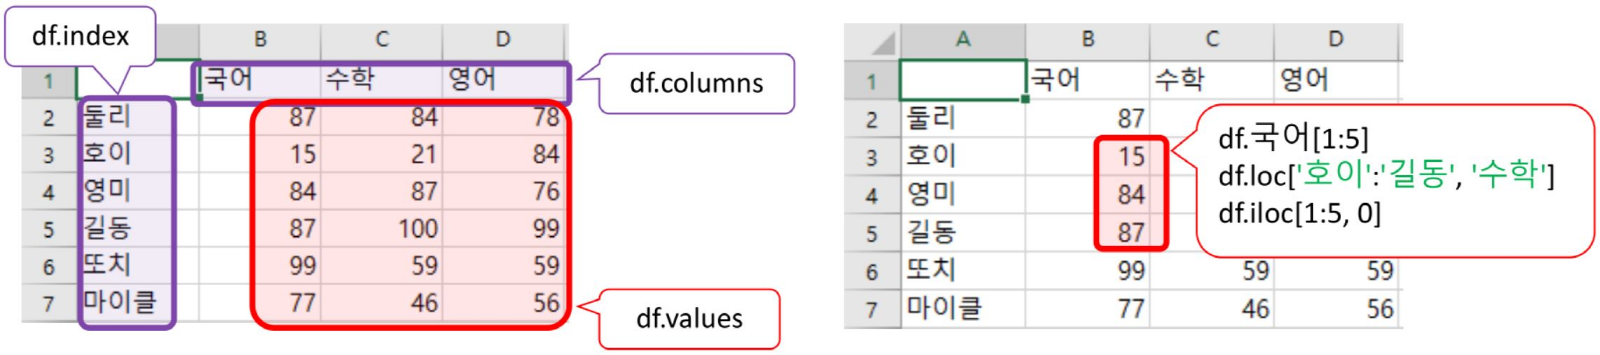
data.loc['Colorado', ['two', 'three']]print(data.iloc[2, [3, 0, 1]]) print('----------------------') print(data.iloc[2]) print('----------------------') print(data.iloc[[1, 2], [3, 0, 1]]) print('----------------------') print(data.loc[:'Utah', 'two']) print('----------------------') print(data.iloc[:, :3][data.three > 5]) - 정수 인덱스 사용하기
- 정수 인덱스
- 순서가 있는 데이터 구조(sequence types)의 개별 요소에 접근하는 기본적인 방법
- 문자열(문자의 순서), 리스트(항목의 순서), 튜플(변경 불가능한 항목의 순서)
- 사용자가 지정한 문자열 인덱스가 아닌 기본 인덱스를 생각하면 됨
  ser = pd.Series(np.arange(3.))
  ser
ser2 = pd.Series(np.arange(3.), index=['a', 'b', 'c']) ser2ser2[-1]print(ser[:1]) print('----------------------') print(ser.loc[:1]) print('----------------------') print(ser.iloc[:1]) - 순서가 있는 데이터 구조(sequence types)의 개별 요소에 접근하는 기본적인 방법
- 정수 인덱스
5.4 산술 연산
-
기본 산술 연산
  s1 = pd.Series([7.3, -2.5, 3.4, 1.5], index=['a', 'c', 'd', 'e'])
  s2 = pd.Series([-2.1, 3.6, -1.5, 4, 3.1], index=['a', 'c', 'e', 'f', 'g'])

  s1 + s2
df1 = pd.DataFrame(np.arange(9.).reshape((3, 3)), columns=list('bcd'), index=['Ohio', 'Texas', 'Colorado']) df2 = pd.DataFrame(np.arange(12.).reshape((4, 3)), columns=list('bde'), index=['Utah', 'Ohio', 'Texas', 'Oregon']) df1 + df2df1 = pd.DataFrame({'A': [1, 2]}) df2 = pd.DataFrame({'B': [3, 4]}) df1 - df2 - 산술연산 메소드에 채워넣을 값 지정하기
- 산술연산 메소드: add, sub, div, mul
df1 = pd.DataFrame(np.arange(12.).reshape((3, 4)), columns=list('abcd')) df2 = pd.DataFrame(np.arange(20.).reshape((4, 5)), columns=list('abcde'))df2.loc[1, 'b'] = np.nan df2df1 + df2df1.add(df2, fill_value=0)1 / df1df1.rdiv(1)df1.reindex(columns=df2.columns, fill_value=0) -
DataFrame과 Series 간 연산
import numpy as np arr = np.arange(12.).reshape((3, 4))arr[0]arr - arr[0]import pandas as pd frame = pd.DataFrame(np.arange(12.).reshape((4, 3)), columns=list('bde'), index=['Utah', 'Ohio', 'Texas', 'Oregon']) series1 = frame.iloc[0] series2 = pd.Series(range(3), index=['b', 'e', 'f']) series3 = frame['d'] frame - series1 frame + series2 frame.sub(series3, axis='index')
5.5 정렬과 순위
- 정렬
- 인덱스 기반 정렬
  obj = pd.Series(range(4), index=['d', 'a', 'b', 'c'])
  obj.sort_index()
frame = pd.DataFrame(np.arange(8).reshape((2, 4)), index=['three', 'one'], columns=['d', 'a', 'b', 'c']) frame.sort_index() frame.sort_index(axis=1) frame.sort_index(axis=1, ascending=False) -
밸류(값) 기반 정렬
  obj = pd.Series([4, 7, -3, 2])
  obj.sort_values()
obj = pd.Series([4, np.nan, 7, np.nan, -3, 2]) obj.sort_values()frame = pd.DataFrame({'b': [4, 7, -3, 2], 'a': [0, 1, 0, 1]}) frame.sort_values(by='b') frame.sort_values(by=['a', 'b'])
- 인덱스 기반 정렬
-
순위
  obj = pd.Series([7, -5, 7, 4, 2, 0, 4])
  obj.rank()    # Series와 DataFrame의 rank 메소드는 동점인 항목에 대해서는 평균 순위를 매김
  obj.rank(method='first')    # 데이터 상에서 나타나는 순서에 따라 순위 매기기
  obj.rank(ascending=False, method='max')   # 내림차순 순위 매기기
frame = pd.DataFrame({'b': [4.3, 7, -3, 2], 'a': [0, 1, 0, 1], 'c': [-2, 5, 8, -2.5]}) frame.rank(axis='columns')
5.6 중복 색인
obj = pd.Series(range(5), index=['a', 'a', 'b', 'b', 'c'])
obj.index.is_unique
print(obj['a'])
print('----------------------')
print(obj['c'])
df = pd.DataFrame(np.random.randn(4, 3), index=['a', 'a', 'b', 'b'])
df.loc['b']
5.7 기술통계 계산과 요약
-
기본 통계와 요약
  df = pd.DataFrame([[1.4, np.nan], [7.1, -4.5],
                  [np.nan, np.nan], [0.75, -1.3]],
                  index=['a', 'b', 'c', 'd'],
                  columns=['one', 'two'])

  df.sum()
  df.sum(axis='columns')
  df.mean(axis='columns', skipna=False)
  df.idxmax()
  df.cumsum()
  df.describe()
obj = pd.Series(['a', 'a', 'b', 'c'] * 4) obj.describe() -
상관관계와 공분산
  price = pd.read_pickle('https://github.com/SkyLectures/LectureMaterials/raw/refs/heads/main/datasets/S01-01-04-03_01-YahooPrice.pkl')      # 야후 금융사이트에서 구한 주식 가격
  price
volume = pd.read_pickle('https://github.com/SkyLectures/LectureMaterials/raw/refs/heads/main/datasets/S01-01-04-03_01-YahooVolume.pkl') # 야후 금융사이트에서 구한 시가 총액 volumereturns = price.pct_change() # 각 주식의 퍼센트 변화율 returnsreturns.head(3) returns.tail(10)returns['MSFT'].corr(returns['IBM']) # corr 메소드: NA가 아니고 정렬된 색인에서 연속하는 두 Series에 대한 상관관계 계산 returns.MSFT.corr(returns.IBM) # 같은 결과 returns.corr() # DataFrame의 corr 메소드: DataFrame 행렬상에서의 상관관계returns['MSFT'].cov(returns['IBM']) # cov 메소드: NA가 아니고 정렬된 색인에서 연속하는 두 Series에 대한 공분산 계산 returns.cov() # DataFrame의 cov 메소드: DataFrame 행렬상에서의 공분산returns.corrwith(returns.IBM) # DataFrame의 corrwith 메소드: 다른 Series나 DataFrame과의 상관관계 계산. Series를 넘기면 각 Column에 대해 계산한 상관관계를 담고 있는 Series 반환 returns.corrwith(volume) # DataFrame의 corrwith 메소드: 다른 Series나 DataFrame과의 상관관계 계산. DataFrame을 넘기면 맞아떨어지는 Column에 대한 상관관계 계산
5.8 함수 적용과 매핑
-
함수의 적용
frame = pd.DataFrame(np.random.randn(4, 3), columns=list('bde'), index=['Utah', 'Ohio', 'Texas', 'Oregon']) np.abs(frame) -
함수와 매핑
def f(x): return pd.Series([x.min(), x.max()], index=['min', 'max'])frame.apply(f) -
람다 함수와 매핑
f = lambda x: x.max() - x.min() frame.apply(f)frame.apply(f, axis='columns')format = lambda x: '%.2f' % x frame.applymap(format)frame['e'].map(format)
5.9 값 세기, 유일 값, 멤버십
-
값 세기
obj = pd.Series(['c', 'a', 'd', 'a', 'a', 'b', 'b', 'c', 'c']) obj.value_counts() pd.value_counts(obj.values, sort=False) -
유일 값
unique_vals = pd.Series(['c', 'b', 'a']) unique_vals -
멤버십과 마스크
  mask = obj.isin(['b', 'c'])

  obj[mask]
to_match = pd.Series(['c', 'a', 'b', 'b', 'c', 'a']) to_matchpd.Index(unique_vals).get_indexer(to_match)data = pd.DataFrame({'Qu1': [1, 3, 4, 3, 4], 'Qu2': [2, 3, 1, 2, 3], 'Qu3': [1, 5, 2, 4, 4]}) result = data.apply(pd.value_counts).fillna(0) result
5.10 누락된 데이터 처리하기
string_data = pd.Series(['aardvark', 'artichoke', np.nan, 'avocado'])
string_data.isnull()
string_data[0] = None
string_data.isnull()
data = Series([1, np.nan, 3.5, np.nan, 7])
data.dropna()
data
data[data.notnull()]
data = DataFrame([[1., 6.5, 3.], [1., np.nan, np.nan],
                [np.nan, np.nan, np.nan], [np.nan, 6.5, 3.]])
data
cleaned = data.dropna()
cleaned
data
data.dropna(how='all') # 모든 값이 NA인 Row 제거
from numpy import nan as NA

data[4] = NA
data
data.dropna(axis=1, how='all')
df = DataFrame(np.random.randn(7, 3))
df
df.loc[:4, 1] = NA
df
df.loc[:2, 2] = np.nan
df
df.dropna(thresh=3) # 몇 개 이상의 값이 들어있는 Row만 남기고 나머지는 모두 Drop시키려면, thresh 파라미터에 원하는 개수를 넣는다.
df.fillna(0)
df.fillna({1: 0.5, 2: -1})
_ = df.fillna(0, inplace=True)
df
df = DataFrame(np.random.randn(6, 3))
df
df.loc[2:, 1] = np.nan
df
df.loc[4:, 2] = np.nan
df
df.fillna(method='ffill')
df.fillna(method='ffill', limit=2)
data = Series([1., np.nan, 3.5, np.nan, 7])
data.fillna(data.mean())