AI/ML 시스템의 End-to-End 개발 공정
MLOps/LLMOps 파이프라인, 파운데이션 모델 적응, 서빙 최적화, 데이터 드리프트 대응 및 AI 거버넌스까지, 엄격한 엔지니어링 공정으로 체계화된 AI/ML 시스템의 개발 공정을 살펴봅니다.
전통적인 폭포수(Waterfall) 모델과 달리, 데이터-모델-운영 파이프라인이 유기적으로 맞물리는 피드백 루프(Continuous Feedback Loop) 기반 공정
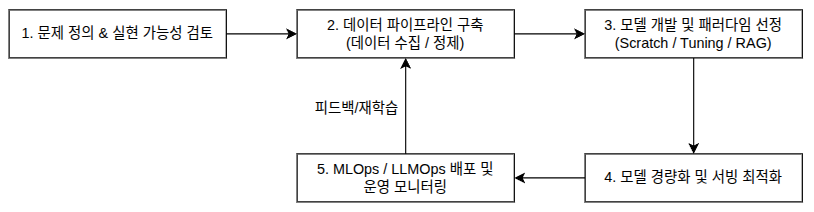 (Source: Sky Lectures / AiDALab)
1. 문제 정의 및 실현 가능성 평가
- 비즈니스 문제의 수식화(Formulation)
- 모호한 비즈니스 요구사항을 측정 가능한 머신러닝/딥러닝 태스크(분류, 회귀, 랭킹, 생성 등)로 전환
- 모델 단독 해결이 아닌 규칙 기반(Rule-based) 엔진 및 도메인 로직과의 결합 구조 설계
- 성공 지표(Evaluation Metrics) 다각화
- 기술 지표 (Technical Metrics):
- Accuracy (정확도):
- 전체 예측 건수 중 맞게 예측한 비율
- 직관적이지만 클래스 불균형 데이터에서는 다수 클래스 편향으로 인해 성능 왜곡이 발생할 수 있음
- F1-score:
- 정밀도(Precision)와 재현율(Recall)의 조화평균
- 불량 탐지나 의료 진단처럼 특정 클래스의 데이터가 극도로 적은 불균형 데이터셋에서 모델의 종합 성능을 평가함
- NDCG (Normalized Discounted Cumulative Gain):
- 검색 엔진이나 추천 시스템에서 사용
- 사용자가 선호하는 상위 랭킹 결과일수록 더 높은 가중치를 부여해 추천 순서의 품질을 측정
- ROUGE / BLEU:
- 주로 번역(BLEU)이나 텍스트 요약(ROUGE) 태스크에서
- 참조 문장(정답)과 모델 생성 문장 간 n-gram 단어 일치도를 기반으로 생성 품질을 평가
- Perplexity (PPL, 곤혹도):
- 언어 모델이 다음 단어를 예측할 때 느끼는 불확실성의 크기(선택지 수)
- 수치가 낮을수록 모델이 문맥을 자연스럽고 정확하게 이해함을 의미
- 추론 지연 시간 (p99 Latency):
- 전체 추론 요청 중 가장 느린 최상위 1% 요청의 응답 시간
- 평균값에 가려진 극단적인 병목(지연 튀는 현상)을 식별해 실시간 서비스 안정성을 보장함
- TPS (Throughput, 초당 처리량):
- 단위 시간(1초)당 시스템이 성공적으로 처리하는 요청 또는 토큰의 수
- 대용량 트래픽 상황에서 서빙 인프라의 처리 역량을 평가함
- Accuracy (정확도):
- 비즈니스 지표 (Business Metrics):
- ROI (투자 자본 수익률):
- AI 모델 도입 및 인프라 구축·운영에 투입된 총비용 대비 창출된 재무적 이익(매출 증대, 비용 절감)의 비율
- 전환율 (CVR, Conversion Rate):
- 추천이나 검색 등 AI 모델의 출력을 접한 전체 사용자 중 구매, 클릭, 회원가입 등 목표 행동을 수행한 사용자의 비율
- 작업 시간 단축율:
- AI 자동화 도구 도입 전후의 업무 소요 시간을 비교한 비율
- 현업 작업자의 생산성 향상과 수작업 공수 절감 효과를 측정
- 불량 탐지율:
- 제조 및 품질 검사 공정에서 발생한 실제 결함품 중 AI 비전/이상 탐지 모델이 정상적으로 식별해 낸 비율
- 직접적인 수율 및 품질 리스크 관리와 직결됨
- 인프라 비용 한계 (GPU Cost):
- 모델 서빙 및 주기적 재학습에 소모되는 클라우드/하드웨어 유지 비용의 상한선
- AI 시스템 운영 비용이 비즈니스 수익성을 훼손하지 않도록 통제하는 지표
- ROI (투자 자본 수익률):
- 기술 지표 (Technical Metrics):
- Feasibility & PoC 설계
- 가용 데이터의 양과 라이선스, 개인정보 보호(GDPR/PII) 리스크 사전 검토
- 베이스라인(Heuristic/Simple Model) 구축을 통한 모델 도입의 실익 사전 검증
2. 데이터 엔지니어링: Data-Centric 접근법
-
현대 AI 공정은 “코드 고정, 데이터 개선(Data-Centric AI)” 패러다임으로 무게중심이 이동했습니다.
- 데이터 수집 및 수집 파이프라인
- 정형(DB/센서/ERP/MES), 비정형(텍스트, 로그, 이미지, 음성) 수집 파이프라인 구축
- 실시간 스트리밍(Kafka, Spark) 및 배치 파이프라인의 분리 구축
- 데이터 정제 및 품질 보증(Data Quality)
- 결측치·이상치 정제 및 피처 스케일링, 인코딩
- 데이터 누수(Data Leakage) 원천 차단: 훈련/검증 분리 시점의 시간 축(Temporal Split) 엄격 적용
- 피처 스토어(Feature Store) 및 버전 관리
- 학습/서빙 간 불일치(Training-Serving Skew) 방지를 위한 Feature Store 도입
- DVC(Data Version Control)를 활용한 데이터셋 및 피처 스냅샷 버전 관리
- 라벨링 및 합성 데이터(Synthetic Data) 활용
- Active Learning을 도입하여 모델이 불확실해하는 데이터 우선 라벨링
- 특수 도메인 및 불균형 클래스 해결을 위한 LLM/확산 모델 기반 합성 데이터 생성
1.3 모델 개발 및 패러다임 선정
해결 과제의 성격에 따라 최적의 모델링 전략을 분기하여 채택