데이터 기반 사업 최적화
분석과 예측의 차이점, 사업재편 타당성 확보를 위한 데이터 기반 의사결정 방식 이해
1. 분석과 예측의 차이
-
두 영역은 바라보는 시점과 던지는 질문의 본질이 완전히 다름
- 분석 (Analysis) 🡪 “과거에 무슨 일이 왜 일어났는가?”
- 이미 기록된 과거 데이터를 분해하고 요약하여 원인, 상관관계, 병목 지점을 파악
- 예시: 지난달 결산 보고서를 보며 “설비 유지보수비가 왜 계획보다 20% 초과했는지” 정리하는 과정
- 이미 기록된 과거 데이터를 분해하고 요약하여 원인, 상관관계, 병목 지점을 파악
- 예측 (Prediction) 🡪 “앞으로 어떤 일이 일어날 것인가?”
- 과거 데이터에서 발견한 규칙(패턴)을 바탕으로, 조건이 바뀌었을 때 미래의 수치나 상태를 가늠
- 예시: 목적지까지 남은 거리, 도로 상황, 날씨를 고려해서 “지금 속도로 가면 30분 뒤 정확히 도착할 수 있는가?”를 계산하는 과정
- 과거 데이터에서 발견한 규칙(패턴)을 바탕으로, 조건이 바뀌었을 때 미래의 수치나 상태를 가늠
-
분석 vs 예측
구분 분석 (Analysis) 예측 (Prediction) 시간 축 과거 ~ 현재 현재 ~ 미래 주요 결과물 대시보드, 통계 차트, 원인 분석 보고서 미래 확률, 예상 수치, 시나리오별 결과 품질/수율 비유 “지난 분기 불량률이 왜 4.2%까지 치솟았는가?” “원자재 배합비와 온도를 A로 바꾸면 불량률이 몇 %가 될까?” 의사결정 연결 책임 소재 파악, 과거 프로세스 반성 리스크 사전 차단, 자원 배분 최적화
2. 데이터 기반 의사결정이 필수인 이유
- 사업재편(비즈니스 전환, 라인 변경, 신규 아이템 도입 등)은 기존 방식의 틀을 깨는 작업
-
이때 기업이 가장 경계해야 할 위험은 ‘과거의 성공 경험에 기인한 직관’
- 감(Intuition)에 의존한 의사결정의 한계:
- “내가 이 라인을 20년간 담당했는데, 이 정도 세팅이면 충분히 수율 95% 나옵니다.”
🡪 설비, 원자재 규격, 작업 환경이 바뀌면 과거의 직관은 작동하지 않거나 치명적인 결함 비용을 초래함
- “내가 이 라인을 20년간 담당했는데, 이 정도 세팅이면 충분히 수율 95% 나옵니다.”
- 단순 데이터 참조 결정:
- 과거 평균 수치만 보고 결정 🡪 복합 변수 간의 충돌(예: 속도를 올리면 품질이 깨지고, 온도를 낮추면 불량이 늚)을 해결하지 못함
- 감(Intuition)에 의존한 의사결정의 한계:
- 데이터 기반 의사결정(Data-Driven Decision Making):
- “직관을 버리는 것”이 아니라, “가설을 세우고 이를 데이터와 모델로 검증하는 체계”
- 의사결정권자에게 막연한 확신 대신 정량적 근거(확률, 기대 수율, 손실 범위)를 제공함
- 여러 제약 조건 속에서 최적의 균형점(Trade-off)을 도출 🡪 리스크를 수치로 검증하며 전진
3. 실무 예시로 이해하는 사업재편 시나리오
-
전통 내연기관 부품 생산 라인 🡪 친환경 미래차 부품 라인으로 전환(사업재편)하는 가상 제조 기업의 사례
- [1 단계] 분석 단계 (과거 데이터 정리 및 병목 파악)
- 상황: 기존 프레스/조립 공정의 3년간 이력 데이터를 취합
- 발견:
- 금형 온도 편차가 5℃ 이상 벌어질 때 크랙 불량이 3배 급증했고
- 야간 교대조에서 조립 오차가 평균 12% 높았음
- 역할: 무엇이 수율을 떨어뜨리는 핵심 변수인지 ‘공정 요인 목록’을 확정
- [2 단계] 예측 단계 (사업재편 시나리오 사전 시뮬레이션)
- 상황: 신규 경량 알루미늄 배터리 팩 케이스 라인 도입 검토
- 예측 모델 적용:
- 노코드 툴을 사용해 ‘가열 온도’, ‘압력’, ‘냉각 속도’ 등을 입력 변수로 넣고
- 예상 불량률을 추정
- 도출된 예측:
- 냉각 속도를 분당 15℃로 유지할 경우 초기 3개월 수율은 82%에 머물지만
- 예열 구간을 추가해 온도 편차를 2℃ 이내로 제어하면 93.5%까지 확보 가능함
- [3 단계] 사업재편 타당성 확보 및 실행 (데이터 기반 의사결정)
- 경영진 보고 및 설득:
- 기존 보고 방식:
- 경쟁사도 다 도입했으니 우리도 설비 투자해야 합니다. 🡪 (설득력 부족)
- 데이터 기반 보고 방식:
- 예측 모델 시뮬레이션 결과, 예열 장치(추가 비용 3천만 원)를 선제 도입해야 초기 수율 손실(약 1억 2천만 원)을 예방할 수 있어
총 9천만 원의 회수 효과가 있습니다.
- 예측 모델 시뮬레이션 결과, 예열 장치(추가 비용 3천만 원)를 선제 도입해야 초기 수율 손실(약 1억 2천만 원)을 예방할 수 있어
- 기존 보고 방식:
- 결과: 불확실성이 큰 사업재편 과정에서 경영진의 투자 승인 문턱을 낮추고, 현장 혼선을 최소화
- 경영진 보고 및 설득:
4. 최적화의 구조적 프레임워크
데이터 기반 사업 최적화에서 분석과 예측은 수단일 뿐이고, 본질은 비즈니스 가치(이익 극대화·비용 최소화·리스크 회피)를 만들어내는 실행 체계임
4.1 분석의 4단계 진화 모델
-
데이터를 다루는 성숙도는 단순히 과거를 정리하는 수준(기술적 관점)에서 미래의 행동 지침을 스스로 도출(가치 관점)하는 단계로 진화
- 1단계: 묘사적 분석 (Descriptive Analysis) 🡪 “과거 집계”
무슨 일이 일어났는가?- 질문: “지난 분기 불량률과 수율 실적은 얼마였는가?”
- 산출물: 실적 대시보드, 엑셀 피벗 테이블, 월간 생산 보고서
- 한계: 현상을 나열할 뿐 왜 그런 일이 벌어졌는지는 말해주지 못함
- 2단계: 진단적 분석 (Diagnostic Analysis) 🡪 “원인 규명”
왜 일어났는가?- 질문: “왜 특정 라인에서만 크랙(균열) 불량이 급증했는가?”
- 산출물: 상관관계 그래프, 공정 조건별 편차 분석, 병목 요인 보고서
- 한계: 문제 원인은 알았으나, 공정 조건을 새로 바꿀 때의 미래 결과는 알 수 없음
- 3단계: 예측적 분석 (Predictive Analysis) 🡪 “미래 추정”
앞으로 무슨 일이 일어날까?- 질문: “신규 합금 소재를 투입하고 온도를 10℃ 올리면 수율이 몇 % 나올 것인가?”
- 산출물: 머신러닝 예측 모델, 시나리오별 예상 수율 및 결함 확률
- 한계: 예상 결과만 던져줄 뿐, 어떤 조건의 조합이 우리에게 가장 이익인지 스스로 결정하지는 못함
- 4단계: 처방적 최적화 (Prescriptive Optimization) 🡪 “실행 방안 도출” ★ 핵심
그럼 어떻게 해야 하는가?- 질문: “전력비는 10% 아끼면서 수율 95% 이상을 달성하려면 공정 압력과 속도를 각각 얼마로 설정해야 하는가?”
- 산출물: 최적의 세팅 레시피(파라미터 조합), 리스크 대비 최대 이익 실행안
- 비유:
- 내비게이션이 단순히 “전방에 폭우로 정체가 예상됩니다(3단계 예측)”에 그치지 않고,
- “통행료 2,000원을 더 내더라도 25분 빠른 3번 우회 국도로 주행하십시오(4단계 최적화)”라고 구체적 행동을 제시하는 단계
- 1단계: 묘사적 분석 (Descriptive Analysis) 🡪 “과거 집계”
4.2 비즈니스 최적화의 3대 요소
- 목적 함수 (Objective): 무엇을 극대화하거나 최소화할 것인가?
- 극대화할 대상(성과·수율·영업이익) 또는 최소화할 대상(불량률·가동 중단 시간·원자재 폐기 비용)을 숫자로 정의
- 예시:
- 신사업 전환 초기 3개월간 원소재 스크랩 비용 최소화
- 양산 안정화 단계의 복합 수율 96% 달성
- 사업재편 전환 기간 단축 등
- 의사결정/조절 변수 (Control Variables): 우리가 현장에서 직접 바꿀 수 있는 것은 무엇인가?
- 실무자가 직접 통제할 수 있는 입력값
- 통제 불가능한 외부 요인(환율, 외부 기온)과 명확히 구분해야 함
- 예시: 설비 가열 챔버 온도, 사출 압력 설정값, 라인 이송 속도, 일일 투입 작업자 수, 설비 점검 주기, 재고 안전 재고량 등
- 제약 조건 (Constraints): 현실적으로 지켜야 하는 한계선은 무엇인가?
- 품질 기준, 물리적 설비 용량, 자금 한도, 납기일, 안전 법규 등 현실적인 제약 사항
- 예시:
- 설비 모터 허용 전력 150kW 이하
- 원자재 허용 인장강도 규격 오차 ±1.5% 이내
- 추가 설비 투자 예산 5천만 원 이내
- 고객사 납기일(D-30)
- 법적 안전 규격 준수 등
4.3 사업재편 시 직면하는 3가지 최적화 영역
| 최적화 영역 | 주요 고민 (실무 과제) | 데이터 기반 해결 방식 |
|---|---|---|
| 공정·품질 최적화 | 신제품 라인 세팅 시 초기 수율 불량으로 인한 시제품 손실을 줄이고 양산 수율을 조기 안정화할 방법은? |
과거 유사 라인의 센서·공정 데이터와 신규 시제품 소량 데이터를 결합해 초기 양산 수율을 극대화하는 '설비 최적 파라미터' 조합 사전 추출 |
| 자원·일정 최적화 | 구사업(축소)에서 신사업(확장)으로 전환할 때, 인력·설비·예산을 어느 타이밍에 넘길 것인가?(재배치) |
기존 라인의 잔여 수주 물량 납기와 신규 라인 램프업(Ramp-up) 곡선을 연동해 생산 공백과 유휴 인력이 최소화되는 '단계적 전환 스케줄' 도출 |
| 원가·수익성 최적화 | 초기 수율 불안정성을 고려했을 때 적절한 납품 단가와 손익분기점은 어디인가? |
수율 변동 폭(80%~95%)에 따른 원가 민감도 시뮬레이션을 통해 영업이익 흑자를 유지할 수 있는 마지노선 단가 및 생산 로트(Lot) 크기 결정 |
4.4 Trade-off를 해결하는 데이터 시뮬레이션
- 현실의 문제는 하나를 얻으면 다른 하나를 잃는 상충 관계(Trade-off)로 이루어져 있음
-
비전문가가 가장 자주 범하는 실수는 한쪽 지표만 보고 의사결정을 내리는 것
- 현장의 전형적인 충돌 시나리오:
- 속도 vs 품질: 라인 가동 속도를 20% 올리면 🡪 생산량은 늘지만, 가열 불균일로 불량률이 3%에서 8%로 뜀
- 원가 vs 안정성: 원자재를 저렴한 대체품으로 바꾸면 🡪원가는 15% 줄지만, 설비 마모율이 높아져 정비 주기와 라인 셧다운 위험이 커짐
-
직관의 한계: 대충 속도 조금 낮추고 품질 챙기자” 식의 타협은 최선책이 아님
- 데이터 시뮬레이션의 역할:
- “속도를 단계별로 올릴 때 발생하는 추가 매출”과 “불량률 상승으로 인한 손실액 + 폐기 비용”을 단일 화폐 단위(원화)로 환산
- 두 곡선이 교차하며 전체 영업이익이 정점에 달하는 ‘최적 균형점’을 검출
5. 실행 로드맵
-
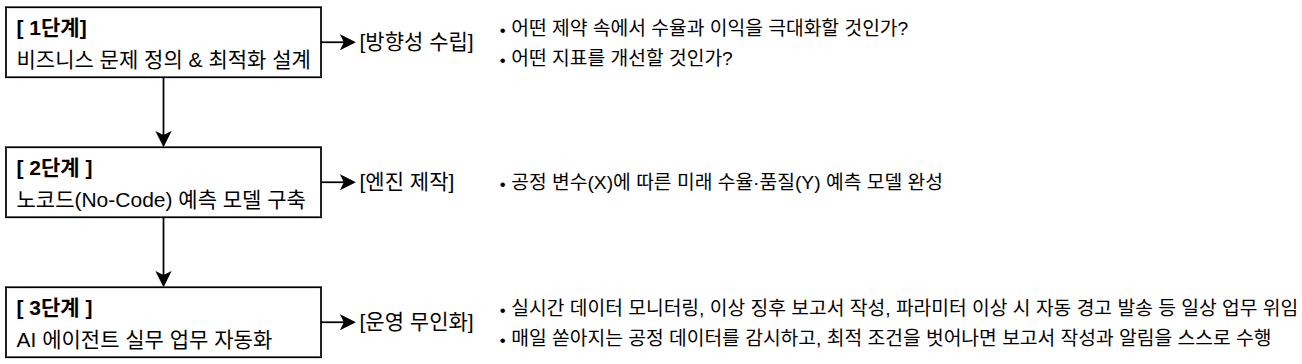
문제 정의🡪 노코드 예측 🡪 AI 에이전트 자동화
 (Source: Sky Lectures / AiDALab)
- 1단계 (문제 정의 & 최적화 설계):
- 어떤 공정 변수가 핵심 레버인지 식별하고 제약 조건을 명문화
- 2단계 (노코드 예측 모델 구축):
- 코딩 없이 엑셀 데이터 연동만으로 입력값에 따른 출력 수율을 계산하는 예측 엔진을 구축
- 3단계 (AI 에이전트 자동화):
- 사람이 매번 수작업으로 데이터를 입력하고 모니터링하지 않도록 AI 에이전트가 공정 데이터를 상시 점검하고
- 이상치 발생 시 최적 조치 권고안을 포함한 보고서를 자동 작성하도록 연동
- 1단계 (문제 정의 & 최적화 설계):
