사업재편 공정 예측 모델 개요
신규 제품 생산 시 불량·수율 예측 모델 작동 원리 및 적용 조건, 실패 원인 분석
- 1. 사업재편 공정 예측 모델 개요
- 2. 불량·수율 예측 모델의 작동 원리
- 3. 현장 적용을 위한 4가지 필수 전제 조건
- 4. 사업재편 공정 모델 도입 시 주요 실패 원인
- 5. 단계별 적용 요약 매트릭스
1. 사업재편 공정 예측 모델 개요
- 사업재편(신규 제품군 전환, 친환경·경량화 라인 신설, 공정 통합 등)에서 직면하는 가장 큰 위험은
- 초기 수율 램프업(Ramp-up) 지연
- 원자재 폐기 손실
- 기존 양산 라인에서는 수년간 축적된 현장 작업자의 직관과 검증된 세팅값(Standard Recipe)이 작동하지만,
-
신규 제품 라인은 물성, 열전도율, 금형 규격, 가공 속도가 완전히 달라져 과거의 경험이 통하지 않음
- 사업재편 시의 대응 방식
- 사후 대응(시행착오 방식):
- 설비를 가동한 뒤 불량이 발생하면 파라미터를 조금씩 조정하며 수율을 끌어올리는 방식
- 수천만 원에서 수억 원에 달하는 시제품 원소재 폐기 비용과 납기 지연을 유발함
- 사전 예측(예측 모델 방식):
- 설비를 본격 가동하기 전, 투입되는 원자재 물성 데이터와 공정 설정값(온도, 압력, 속도)을 가상 모델에 입력
- “이 조건으로 가동했을 때 불량이 발생할 확률과 예상 수율”을 사전에 계산하고 최적 조건을 선제 설정 반영
- 사후 대응(시행착오 방식):
2. 불량·수율 예측 모델의 작동 원리
-
머신러닝 예측 모델의 기본 원리는 수학 공식이 아니라
원인(입력)과 결과(출력) 사이의 숨은 연결 고리(패턴)를 찾는 것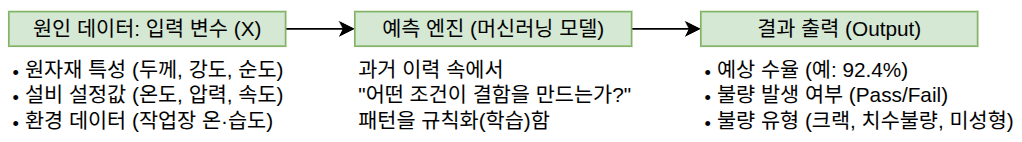 (Source: Sky Lectures / AiDALab)
-
작동의 3단계 흐름
- 데이터 수집 및 정렬 🡪 Feature & Target 매핑
- 입력 변수 ($X$, Feature):
- 제품 품질에 영향을 주는 모든 가공 조건
- 예: 가열 챔버 온도, 사출 압력, 냉각 시간, 원자재 로트별 인장강도
- 제품 품질에 영향을 주는 모든 가공 조건
- 타깃 변수 ($Y$, Target):
- 우리가 알고 싶은 최종 결과
- 분류(Classification) 모델:
- 합격인가, 불량인가?
- Pass / Fail / 불량 유형 A, B, C 등
- 합격인가, 불량인가?
- 회귀(Regression) 모델:
- 수율이 정확히 몇 %인가?
- 치수 오차가 몇 mm인가? 등
- 입력 변수 ($X$, Feature):
- 학습(Training) 단계 🡪 규칙 발견
- 모델은 수백~수만 건의 과거 데이터를 훑으며
- “가열 온도가 220℃를 넘어가고 압력이 80bar 미만일 때 크랙 불량이 85% 확률로 발생한다”는 식의
- 다차원 비선형 규칙을 찾아냄
- 추론(Inference) 단계 🡪 미래 예측
- 신규 제품을 생산할 때, 엔지니어가 계획한 설비 파라미터($X$)를 입력하면
- 모델이 즉시 예상 수율과 불량 위험도($Y$)를 화면에 출력함
- 데이터 수집 및 정렬 🡪 Feature & Target 매핑
3. 현장 적용을 위한 4가지 필수 전제 조건
- 노코드 툴을 사용하더라도 데이터와 공정 환경이 갖추어지지 않으면 모델은 무용지물
-
실무에서 반드시 점검해야 할 4가지 조건
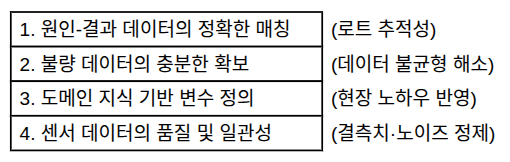 (Source: Sky Lectures / AiDALab)
- 원인과 결과 데이터의 매칭(Lot Tracking):
- 설비 센서 로그(온도, 압력)와 품질 검사기 결과(검사 합부 판정)가 제품 로트(Lot ID)나 타임스탬프로 1:1 결합되어야 함
- “설비는 계속 돌았는데 어느 제품이 불량인지 모른다”면 모델을 학습시킬 수 없음
- 불량 데이터의 다양성 확보 (데이터 불균형 문제):
- 머신러닝은 ‘정상’과 ‘불량’을 모두 보아야 둘을 구분할 수 있음
- 기존 공정의 불량률이 0.5% 미만인 극단적 정상 데이터만 있다면,
- 모델은 무조건 “정상”이라고만 응답
- 신규 라인 세팅 시에는
- 의도적인 한계 시험(Limit Test) 데이터나
- 유사 공정의 과거 불량 데이터가 포함되어야 함
- 머신러닝은 ‘정상’과 ‘불량’을 모두 보아야 둘을 구분할 수 있음
- 현장 엔지니어의 도메인 지식 반영 (Feature Selection):
- 단순히 수백 개 센서값을 무작정 밀어 넣으면 모델이 혼란에 빠짐(차원의 저주)
- “품질에 결정적 영향을 주는 5~10가지 핵심 파라미터”를 현장 전문가가 먼저 추려주어야 높은 정확도를 얻을 수 있음
- 측정 데이터의 신뢰성:
- 다음과 같은 내용들이 사전에 정제(Preprocessing)되어야 함
- 센서 드리프트(시간 경과에 따른 영점 이탈)
- 작업자 교대 간 검사 기준 편차
- 누락된 결측치 등
- 다음과 같은 내용들이 사전에 정제(Preprocessing)되어야 함
- 원인과 결과 데이터의 매칭(Lot Tracking):
4. 사업재편 공정 모델 도입 시 주요 실패 원인
- 수많은 스마트팩토리 및 AI 도입 프로젝트가 개념 검증(PoC) 이후 현장에 안착하지 못하고 실패하는 원인은
-
기술 자체보다 공정 환경과 데이터의 특수성에 있음
- 원인 1. 데이터 분포 이동 (Data Drift / Covariate Shift)
- 현상:
- 파일럿 테스트에서는 정확도 95%가 나왔는데 🡪 양산 1개월 차부터 정확도가 60%대로 급락함
- 이유:
- 신규 제품으로 라인을 전환하면서 원자재 공급사가 바뀌었거나,
- 계절 변화(여름철 습도 상승), 금형 마모 등 과거 학습 데이터에 없던 새로운 환경 요인이 발생했기 때문
- 대응책:
- 주기적으로 최신 양산 데이터를 추가 학습(재학습 파이프라인)시키는 체계가 필요함
- 현상:
- 원인 2. 불량 데이터 부족에 의한 ‘모두 정상’ 판정 왜곡
- 현상:
- 모델 정확도가 99%라고 보고되었으나 🡪 현장에서는 무용지물 취급을 받음
- 이유:
- 전체 10,000개 데이터 중 불량이 10개뿐인 경우, 모델이 모든 입력을 “정상”으로 찍어도 정확도는 99.9%
- 이는 진짜 불량을 단 하나도 잡아내지 못하는 실패한 모델
- 대응책:
- 단순 ‘정확도(Accuracy)’ 대신
- 불량을 얼마나 놓치지 않는지 나타내는 ‘재현율(Recall)’과 ‘정밀도(Precision)’를 평가지표로 사용해야 함
- 현상:
- 원인 3. 상관관계와 인과관계의 혼동
- 현상:
- 모델이 “모터 회전수가 올라가면 불량이 준다”고 예측하여 속도를 올렸더니 🡪 대량 불량 발생
- 이유:
- 실제로는 “작업 숙련도가 높은 주간 근무자가 모터 속도를 빠르게 설정했던 것”인데,
- 모델은 작업자의 숙련도가 아닌 모터 속도만을 성공 요인으로 오인한 것
- 대응책:
- 현장 설비의 물리적 메커니즘과 충돌하는 예측 규칙은 🡪 엔지니어의 도메인 검증을 통해 걸러내야 함
- 현상:
- 원인 4. 현장 작업자의 모델 불신 (블랙박스 문제)
- 현상:
- 모델이 특정 파라미터로 세팅하라고 추천해도
- 작업자가 이를 무시하고 기존 방식 고수
- 이유:
- “왜 이 온도로 설정해야 하는지” 이유를 설명하지 못하는 AI 결과는 🡪 현장 작업자에게 불안감을 줌
- 대응책:
- 어떤 입력 변수가 예측 결과에 가장 큰 영향을 주었는지 보여주는
- 설명 가능한 AI(XAI, 변수 중요도 차트 등) 기능이 제공되는 노코드 도구를 도입해야 함
- 현상:
5. 단계별 적용 요약 매트릭스
| 구축 단계 | 주요 활동 내용 | 실무 점검 포인트 (Checklist) |
|---|---|---|
| 1. 문제 정의 | 불량 유형(크랙, 치수, 외관) 또는 목표 수율 정의 | 분류(Pass/Fail)인지 수치 예측(수율 %)인지 결정 |
| 2. 데이터 수집·정합 | 설비 PLC/센서 데이터 + 검사 데이터 결합 | 타임스탬프와 Lot ID의 일치 여부 확인 |
| 3. 노코드 모델 학습 | 알고리즘 자동 탐색(AutoML) 및 모델 훈련 | 데이터 불균형 여부 확인 및 재현율(Recall) 검토 |
| 4. 해석 및 검증 | 변수 중요도(Feature Importance) 분석 | 물리적 공정 상식과 일치하는지 현장 확인 |
| 5. 현장 배포 및 운영 | 신규 파라미터 세팅 전 사전 시뮬레이션 적용 | 공정 조건 변화 시 모델 재학습 주기 수립 |
