인공지능과 제조 데이터 구조의 이해
인공지능 개요와 제조 데이터 특성(정형·비정형·시계열) 이해
1. AI란 무엇인가?
- 흔히 생각하는 인공지능이란?
- 컴퓨터를 이용하여 사람의 지능을 구현한 시스템?
- 사람보다 뛰어난 능력을 보유하므로 인류에게 큰 도움을 주거나 인류에게 큰 위협이 될 수 있는 존재?
- 그러나… 특이점이라는 것이 발생한 후의 미래형 초 인공지능이라면 모를까..
- 그런 인공지능은 현재로선 불가능
1.1 AI 개요
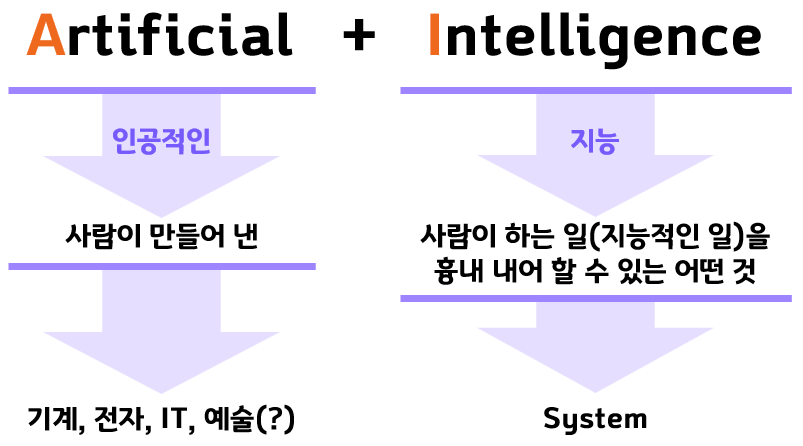 (Source: Sky Lectures / AiDALab)
- 흔히 볼 수 있는 두루뭉술한 인공지능의 정의를 생각하게 되면 산업에서의 적용은 오히려 어려워짐
- 책에서 볼 수 있는 상상 속의 인공지능에 대한 개념은 잠시 접어둘 것
- 인공지능(AI)란..
- 다양한 기술을 이용하여 사람이 하는 일을 흉내내어 처리할 수 있는 시스템
- 다양한 기술이란?
- 기계, 전자, 컴퓨터 등 공학적인 기술
- 예술로 표현할 수 있는 창의성을 포함(하는 것을 목표로 함)
- 다양한 기술이란?
- 정의가 애매한 이유는 무엇일까?
- 먼저 “지능”에 대한 정의가 명확하지 않음
- 아직 인간의 지능에 대하여 밝혀진 것이 거의 없기때문에 명확하게 정의할 수 없음
- 인간의 지능에 대하여 명확하게 밝혀지거나 정의되지 않음에 따라
- 인공지능의 구현 방향은 지능적인 것으로 보이는 것을 흉내 내어 보자! ➜ 인간을 흉내 내자! 라는 것으로 귀결됨
- 인간을 흉내내기 위한 방향성
- 기계적인 부분을 흉내 내자
- 그 외의 부분을 흉내………… 어떻게든 해 보자
- 다양한 기술을 이용하여 사람이 하는 일을 흉내내어 처리할 수 있는 시스템
1.2 기존에 연구되던 AI 기술
- 현재, 일반적으로 볼 수 있는 AI 기술은…
- 하나의 개체(인간)가 가지는 생물학적/기계적인 기능을 흉내 낸 것
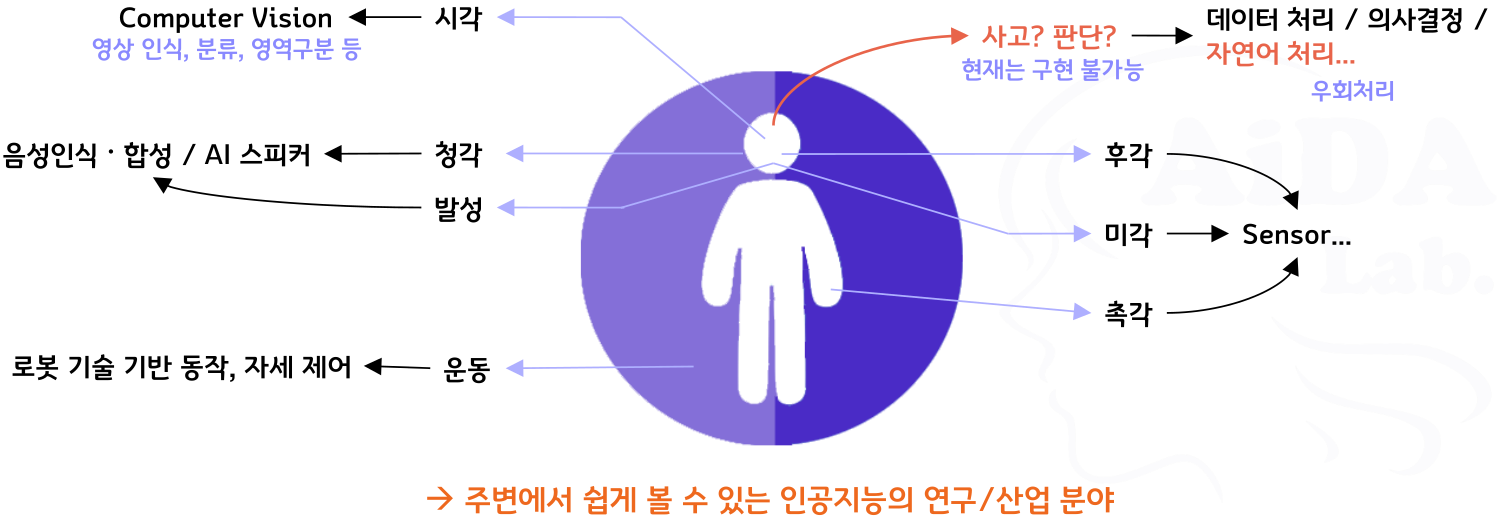 (Source: Sky Lectures / AiDALab)
- 하나의 개체(인간)가 가지는 생물학적/기계적인 기능을 흉내 낸 것
- 그렇다면 비 기계적인 부분(사고과정)은 어떻게?
- 아직 정확한 방법은 나오지 않았음
- 지능이 무엇인지도 모르는데 만들 수 있을리가 없음
- 그래서 비 기계적인 부분(사고과정)은 우회하는 방법을 채택
- 사고과정에서 일어나는(행하는) 일들을 분류함
- 데이터 처리, 의사결정, 예측, 의사소통(언어, 커뮤니케이션), 콘텐츠 생성 등
- 각각에 대한 다양한 연구가 진행됨
-
책 등에서 흔히 볼 수 있는 AI의 개념과 분류
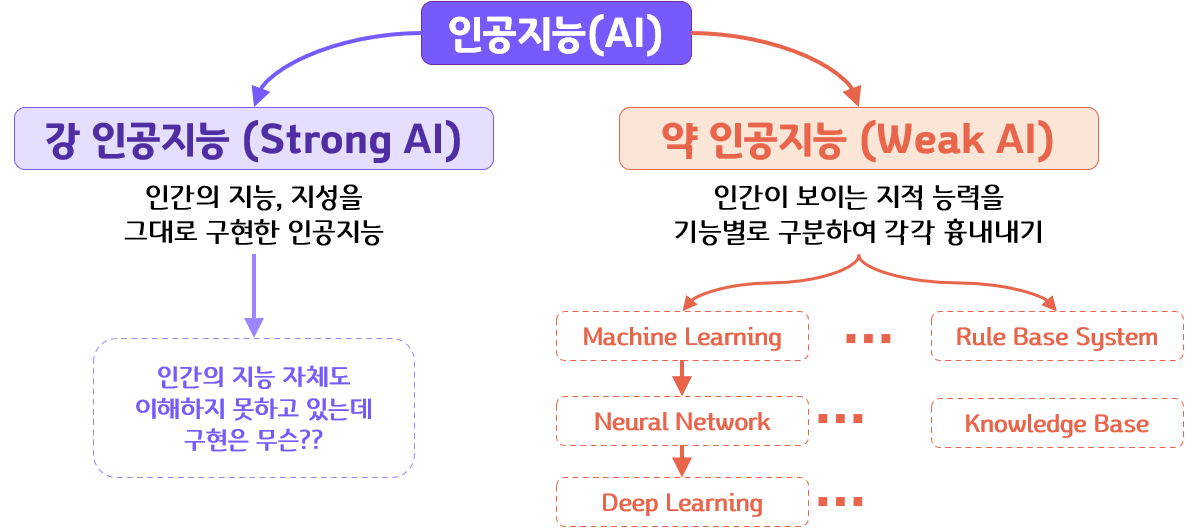 (Source: Sky Lectures / AiDALab)
1.3 자연어 처리 기술과 대형 언어 모델
- 여기서!! ➜ 인간은 사회적인 동물이다!!
- 인간은 크고 작은 사회, 조직 안에서 지식과 지혜를 세대를 거쳐 누적 시킴으로써 문명을 이루었고, 본능과 다른 지성을 성립시켜 옴
- 이 과정에서 사람과 사람 사이의 소통, 커뮤니케이션이 요구됨
- 이런 커뮤니케이션을 위해 발생한 것이 언어, 즉 자연어(Natural Language)
- 언어(자연어)의 발생은…
- 인간이 스스로의 지식을 구조화 할 수 있게 진화 시킴 ➜ 인간의 사고 행위는 언어(자연어)로 구성됨
- 언어의 발생의 의의
- 인간의 진화는 매우 더디게 진행 ➜ 언어의 발생과 함께 폭발적으로 진화
- 언어 발생 이전의 사고 ➜ 단순한 동물이 보이는 기계적인 반응에 그침
- 언어를 사용하면서 ➜ 지식의 구조화 성립, 현대적인 의사소통 능력 발생
-
인간의 사고 능력은 생물학적 기능의 모방으로 구현할 수 없으며, 사고 능력은 언어를 기반으로 성립함
- 또한… 인간의 지능, 지성은 복합적으로 구성됨
- 한 사람, 하나의 개체에만 적용되는 지능, 지성
- 사회를 구성하는 집단에서 발생하는 집단 지성
- 이러한 모든 것을 연결하는 핵심이 언어(자연어)
- 언어(자연어)를 컴퓨터/AI가 처리할 수 있게 되면서 ➜ 단순한 산업, 계산, 예측을 위한 시스템에 인간이 쌓아 올린 문명과 문화가 반영되기 시작
-
자연어 처리 기술의 발전
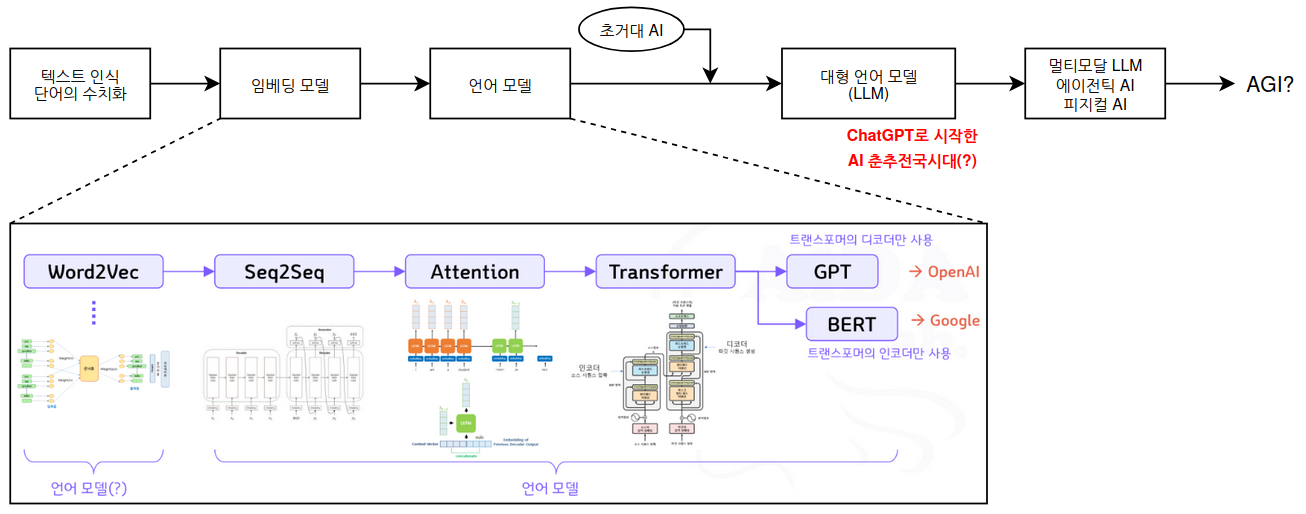 (Source: Sky Lectures / AiDALab)
- AI 기술은 오랜 역사에 비해 최근 몇 년간 급속한 발전을 이루다보니 잘못된 접근 또는 지나치게 추상적이거나 형이상학적인 접근 등이 과도하게 퍼져나간 경향이 있음
- 자신의 업무 등에 적합한 방향으로 접근하는 것이 AI에 대한 이해도와 접근 능력, 응용 능력을 바르게 키울 수 있는 방법임
- AI 기술을 전문적으로 연구해 나갈 계획이 아니라면 전체적인 흐름을 이해하는 선에서 마무리하고 업무에 맞는 활용 방안을 학습하는 것을 권장함
- 실제 AI분야는 흔히 알려진 것보다 오랜 역사를 가지고 있으며 그 연구 방향과 영역도 지금 주목받는 분야보다 폭넓게 진행되어 왔음
- 개인적인 규모로는 따라가는 것조차 힘들 정도로 광범위하고 깊기때문에 자신에게 필요한 범위에 집중하는 것이 좋음
2. 데이터 개요
- 정의
- 현실 세계에서 관찰되거나 측정된 사실이나 값(Fact)
- 현대 정보 사회의 가장 가치 있는 원자재이자, 모든 의사결정과 시스템의 기반이 되는 핵심 자산
- 특징
- 단독으로 존재할 때는 단순한 수치나 문자에 불과하여 큰 의미를 갖지 못함
- 특정 목적에 맞게 가공되고 문맥(Context)이 부여되면 비로소 가치 있는 ‘정보(Information)’로 전환됨
- 예시
- 데이터 (Data): 38 (단순한 숫자)
- 정보 (Information): “오늘 서울의 최고 기온은 38°C이다.” (의미가 부여된 데이터)
- 예시
3. 데이터의 분류
3.1 형태 및 구조화 수준에 따른 분류
- 데이터가 얼마나 일정한 규칙과 틀을 가지고 저장되어 있는지에 따라 구분됨
-
이 분류에 따라 어떤 DBMS(MySQL인지, MongoDB인지)를 사용할지를 결정함
- 정형 데이터 (Structured Data)
- 고정된 필드(틀)에 정해진 형식으로 저장된 데이터
- 특징:
- 연산과 검색이 매우 빠름
- 주로 관계형 데이터베이스(RDBMS)의 표(Table) 형태로 관리됨
- 예시: 이름, 나이, 결제 금액, 날짜, 주소록 등
- 반정형 데이터 (Semi-structured Data)
- 고정된 틀은 없지만, 데이터 내에 구조를 설명하는 메타데이터나 태그(Tag)가 포함된 데이터
- 특징
- 스키마(틀) 변경이 자유로움
- 파일 형태로 교환하기 쉬움
- 예시: JSON, XML, HTML 파일, 설정 파일 등
- 비정형 데이터 (Unstructured Data)
- 형태가 전혀 정해져 있지 않고, 규칙성이 없는 데이터
- 특징
- 텍스트나 바이너리 형태로 존재
- 형태가 다양해 일반적인 테이블 구조에 담을 수 없음
- NoSQL이나 데이터 레이크(Data Lake)에 저장
- 예시: 이미지, 영상, 오디오 파일, SNS 게시글 원문, 이메일 내용 등
3.2 속성과 측정 기준에 따른 분류
- (통계 및 분석 기준에 따른 분류)
- 데이터가 나타내는 값의 성격에 따라 질적 데이터(정성적 데이터)와 양적 데이터(정량적 데이터)로 나뉨
- 이는 주로 SQL로 통계 및 분석 쿼리를 작성할 때 집계 방식을 결정하는 기준이 됨
- 질적 데이터 $\approx$ 정성적 데이터 (숫자가 아닌 성질이나 상태를 나타냄)
- 양적 데이터 $\approx$ 정량적 데이터 (숫자로 크기나 양을 나타냄)
- 질적(Qualitative) 데이터 vs 양적(Quantitative) 데이터
- 주로 ‘통계학’과 ‘데이터베이스(DB)’ 분야에서 데이터를 분류할 때 쓰는 표현
- 데이터의 ‘형태’가 숫자인가, 아닌가에 초점이 맞춰져 있음
분류 정의 특징 예시 질적 데이터
(Qualitative / 범주형)- 데이터의 성질이나 종류를 나타냄
- 숫자로 표현할 수 없거나, 숫자로 표현해도 크기 비교가 불가능한 데이터주로 분류나 그룹화를 할 때 사용함
(GROUP BY 대상)성별(남/여), 혈액형,
상품 카테고리, 거주 지역양적 데이터
(Quantitative / 수치형)- 양이나 크기를 나타냄
- 숫자로 표현되며, 더하기/빼기 등의 산술 연산이 의미가 있는 데이터평균, 합계 등 통계량을 낼 때 사용함
(집계 함수 대상)매출액, 회원 수,
방문 횟수, 기온, 몸무게 - 정성적(Qualitative) 데이터 vs 정량적(Quantitative) 데이터
- 주로 ‘비즈니스 분석’, ‘연구 방법론(설문/인터뷰)’, ‘기획’ 분야에서 데이터의 성격을 말할 때 쓰는 표현
-
데이터가 ‘수치화(측정)하기 쉬운가, 주관적인가’에 초점이 맞춰져 있음
- 정성적 데이터
- 수치로 쉽게 바꾸기 힘든 주관적인 경험, 감정, 생각, 맥락 등을 담은 데이터
- 연구자의 해석이 중요하게 작용함
- 예시: 고객의 심층 인터뷰 녹취록, 제품 사용 후기 원문, 사용자의 행동 관찰 일지
- 정량적 데이터
- 명확하게 자로 재거나 셀 수 있어서, 객관적으로 수치화된 데이터
- 예시: 설문조사의 5점 만점 점수, 웹사이트 이탈률, 월별 매출액
 (Source: Sky Lectures / AiDALab)
3.3 관계 및 구조에 따른 분류
-
데이터가 서로 어떻게 연결되어 있고, 어떤 형태로 시각화·저장되는지에 따른 분류
- 테이블형 데이터 (Tabular Data)
- 특징
- 데이터를 격자 모양의 표(행과 열) 형태로 표현
- 가장 전통적이고 대중적인 구조
- 연결 고리
- 구조화 수준으로 보면 완벽한 정형 데이터에 속함
- MySQL 같은 관계형 데이터베이스(RDBMS)에 저장됨
-
예시: 엑셀 시트, 대학교 학생 명부, 가입자 정보 테이블
 (a) Record Data: 고정된 속성(필드) 집합으로 표현되는 가장 일반적인 레코드 구조
(b) Transaction Data: 개별 사건(거래)별로 연관된 항목(Item)들의 집합으로 구성된 비정형/가변 구조
(c) Data Matrix: 모든 속성이 수치형(Numeric)인 레코드 데이터를 n×p 행렬로 정형화한 형태
(d) Document-Term Matrix (DTM): 텍스트 문서를 수치화하기 위해 문서 × 단어(Term) 빈도로 구성한 행렬
- 특징
- 그래프 기반 데이터 (Graph-based Data)
- 특징
- 데이터 개체들을 점(Node)으로, 개체 간의 관계를 선(Edge)으로 연결하여 표현하는 구조
- 데이터 간의 연관 관계를 추적하는 데 최적화되어 있음
- 연결 고리
- 데이터 구조의 유연성이 높아 반정형 혹은 비정형 데이터의 성격을 가짐
- Neo4j 같은 그래프 데이터베이스(Graph DB)에 저장됨
- 예시: 페이스북의 친구 관계도, 내비게이션의 도로망(지도) 데이터, 웹 페이지의 링크 구조

- 특징
3.4 순서 및 시간에 따른 분류
-
데이터에 ‘순차적인 흐름이나 시간의 개념’이 포함되어 있는지에 따른 분류
- 순서형 데이터 (Sequential Data)
- 특징
- 데이터의 ‘앞뒤 순서(Sequence)’가 결과에 결정적인 영향을 미치는 데이터
- 시간축이 명확하지 않더라도 사건의 발생 순서 자체가 중요함
- 연결 고리
- 텍스트나 자연어는 문맥(순서)이 중요하므로 비정형 데이터인 경우가 많음
- AI 모델(RNN, Transformer)에서 깊게 다룸
- 예시: 문장 속 단어들의 배열(자연어), DNA 염기서열, 웹사이트 방문자의 클릭 경로(Clickstream)
 (a) Sequential transaction data: 시간에 따라 연속적으로 수행한 구매나 행동 사건들의 순서 데이터
(b) Genomic sequence data: 생명체의 유전 정보를 구성하는 염기서열(A, T, G, C)이 물리적으로 길게 나열된 이산적인 문자열 데이터
(c) Temperature time series: 한 고정된 위치에서 시간 흐름에 따라 연속적으로 기록된 기온 변화 데이터
(d) Spatial temperature data: 특정 시점에 여러 지리적 위치(위도, 경도)에 걸쳐 공간적으로 분포된 기온 측정 데이터(예: 기온 열지도)
- 특징
- 시계열 데이터 (Time-Series Data)
- 특징
- ‘일정한 시간 간격’에 따라 순차적으로 기록된 데이터
- 과거의 패턴을 통해 미래를 예측하는 분석에 주로 사용됨
- 연결 고리
- 시간, 센서값 등이 고정된 필드로 들어오면 정형 데이터가 됨
- 무수히 쏟아지는 로그 형태면 반정형 데이터가 됨
- 전용 저장소(InfluxDB, TimescaleDB)를 쓰기도 함
- 예시: 주식 가격 변동 그래프, 1시간 간격의 기온 데이터, 서버의 CPU 사용량 모니터링 로그
 (Source: Sky Lectures / AiDALab)
- 특징
3.5 데이터의 근원에 따른 분류
- 데이터가 생성되는 원천(Source)의 특성과 “한 번 생성된 데이터를 원래 상태로 되돌리거나 유추할 수 있는가”에 초점을 맞춘 엔지니어링 및 보안 중심의 분류 방식
- 데이터 수집과정은 데이터의 재생산 과정에 따름
-
특히 시스템 아키텍처를 설계하거나, 데이터 비식별화(보안), 그리고 데이터 압축/복원 시나리오에서 매우 중요하게 다뤄지는 개념
- 가역 데이터 (Reversible Data)
- 특정 가공이나 변환을 거친 후에도, 반대 연산이나 복원 알고리즘을 통해 원래의 원본 데이터로 100% 완벽하게 되돌릴 수 있는 데이터
- 생산된 데이터의 원본으로 일정 수준 환원이 가능한 데이터
- 특징
- 데이터의 손실이 없어야 하므로 엄격한 규칙성을 가짐
- 정보의 완벽한 보존이 최우선일 때 사용됨
- 원본과 1:1 대응 관계 🡲 환원 가능 🡲 이력추적 가능 🡲 원본 데이터가 변경되는 경우 변경사항 반영 가능
- 주요 예시 및 활용 분야
- 무손실 압축 파일
- .zip, .png, .flac 파일 등은 용량을 줄였다가 다시 압축을 풀면 단 1비트의 오차도 없이 원본으로 복원됨
- 양방향 암호화
- 데이터베이스에 저장된 사용자의 개인정보(예: 주민등록번호, 계좌번호)를 암호화 알고리즘(AES 등)으로 숨겼다가, 권한이 있는 사용자가 조회할 때 복호화(Decryption)하여 원본을 보여주는 케이스
- 수학적 변환 데이터
- 인코딩(Base64)이나 진법 변환된 데이터
- 인코딩(Base64)이나 진법 변환된 데이터
- 무손실 압축 파일
- 특정 가공이나 변환을 거친 후에도, 반대 연산이나 복원 알고리즘을 통해 원래의 원본 데이터로 100% 완벽하게 되돌릴 수 있는 데이터
- 불가역 데이터 (Irreversible Data)
- 데이터가 생성되거나 가공되는 과정에서 원본 정보의 일부 또는 전부가 유실되어, 어떠한 방법을 써도 절대 원래의 원본 데이터로 되돌리거나 유추할 수 없는 데이터
- 재생산 시, 원본 데이터와는 전혀 다른 형태로 재생산됨 🡲 환원 불가
- 특징
- 단방향성(One-way)을 가짐
- 주로 보안 강화, 용량 극대화, 또는 현실 세계의 관측 데이터를 다룰 때 나타남
- 주요 예시 및 활용 분야
- 단방향 해시 함수 (암호학)
- 사용자의 비밀번호를 저장할 때 쓰는 SHA-256, bcrypt 등이 대표적
- 원본 비밀번호를 복잡한 문자열(해시값)로 바꾸는 것은 가능하지만,
- 그 해시값을 역산해서 원본 비밀번호를 알아내는 것은 수학적으로 불가능함
- 손실 압축 파일
- .jpg 이미지, .mp3 음악, .mp4 영상 등은 사람이 인지하지 못하는 미세한 데이터 영역을 강제로 지워 용량을 줄임
- 이 파일들은 다시 압축을 풀어도 지워진 데이터가 돌아오지 않음
- 현실 세계의 자연 현상 데이터
- 센서가 수집한 온도, 습도, 바람의 세기 등은 한 번 측정되어 데이터화되면, 그 데이터만 보고 당시의 대기 상태 전체를 분자 단위로 역추적해 복원하는 것은 불가능함
- 통계적 요약 및 가명화 데이터
- 대형 로그 데이터에서 ‘일별 매출 합계’만 남기고 상세 내역을 지우거나, 개인정보를 알아볼 수 없게 마스킹(예: 홍*동) 처리한 데이터
- 단방향 해시 함수 (암호학)
4. 제조 데이터
- 제조 데이터는 IT 서비스나 일반 비즈니스 데이터와 비교했을 때 물리적 세계(Physical World)와 직결되어 있다는 점에서 독특한 유형과 특성을 가짐
- 일반 데이터 분석의 관점으로 접근하면 현업과의 괴리가 생기기 쉽기 때문에, 이 차이점을 명확히 구분하는 것이 좋음
4.1 시계열 및 고주파 데이터
- 정형/비정형을 넘어선 ‘시계열 및 고주파 데이터’
- 일반적인 비즈니스 데이터가 ‘고객의 구매 행동(이벤트 발생)’ 중심이라면,
-
제조 데이터는 ‘설비의 상태(지속적인 흐름)’ 중심
- 초고속·고주파(High-Frequency) 데이터:
- 센서 데이터(진동, 전류, 압력 등)는 밀리초($ms$) 단위로 수집됨
- 일반 RDBMS가 아닌 Time-Series DB(TSDB)나 NoSQL 중심의 아키텍처가 필수적인 이유
- 다변량 시계열(Multivariate Time-Series):
- 하나의 공정이나 설비에서 수십 개의 센서 데이터가 서로 얽혀서 들어옴
- 단일 변수 분석이 아닌, 상호 연관성을 파악하는 다변량 분석(Multivariate Analysis) 기법이 강조되어야 함
4.2 물리적 도메인 지식의 절대성
- 일반 데이터 분석은 통계적 유의성이나 데이터 자체의 패턴(관계성)에 의존하는 경우가 많음
-
제조 데이터는 물리·화학적 법칙(Causality)을 따름
- 인과관계 규명의 중요성:
- 통계적으로 상관관계가 높게 나와도
- 실제 설비의 메커니즘(열역학, 유체역학, 응력 등) 상 말이 안 되는 결론이라면
- 현업(현장 엔지니어)에서 수용되지 않음
- 물리적 한계치(Boundary) 존재:
- 데이터의 정상 범위를 설정할 때,
- 통계적 이상치(Outlier) 기준(예: $3\sigma$)보다 설비 스펙상의 한계치(Upper/Lower Spec Limit)가 더 절대적인 기준이 됨
4.3 극심한 클래스 불균형
- 제조 현장의 궁극적인 목표는 불량을 줄이고 장비가 고장 나지 않게 하는 것
-
이로 인해 데이터의 형태가 극단적으로 치우침
- 99.9%의 정상과 0.1%의 불량:
- 양품 데이터는 차고 넘치지만,
- 분석가에게 정작 필요한 불량(Anomaly)이나 고장(Failure) 데이터는 극도로 부족함
- 분석 접근법의 차이:
- 일반적인 분류(Classification) 알고리즘보다는,
- 정상 데이터만 학습시켜 이상을 감지하는 단일 클래스 분류(One-Class Classification)나 이상 감지(Anomaly Detection) 기법(Isolation Forest, Autoencoder 등)의 비중이 훨씬 높음
4.4 데이터 수집 환경의 복잡성과 파편화
- 일반 IT 데이터는 처음부터 디지털화된 환경(Web/App 로그)에서 깔끔하게 정제되어 쌓이는 경우가 많음
-
제조 데이터는 이른바 OT(Operational Technology) 영역의 독특한 장벽이 있음
- 프로토콜의 파편화:
- Modbus, OPC-UA, Siemens MPI 등 제조사마다, 설비마다 사용하는 통신 프로토콜이 다름
- 데이터를 분석하기 전, ‘수집 및 표준화’ 단계에서 발생하는 리소스가 전체의 70% 이상을 차지함
- 결측치(Missing Value)의 의미:
- 통신 오류, 센서 오작동, 설비 전원 OFF 등 결측치가 발생하는 원인 자체가 설비의 상태를 대변하는 중요한 힌트가 되기도 함
- 단순히 평균값으로 대체하면 안 됨
- 통신 오류, 센서 오작동, 설비 전원 OFF 등 결측치가 발생하는 원인 자체가 설비의 상태를 대변하는 중요한 힌트가 되기도 함
4.5 피드백 루프와 제어로의 연결
- 일반 분석의 종착지가 ‘리포트 발행’이나 ‘마케팅 타겟팅’이라면,
-
제조 데이터 분석의 종착지는 ‘현장 제어 및 최적화’
- 가상 계측(Virtual Metrology):
- 다음 공정으로 넘어가기 전,
- 이전 공정의 데이터를 기반으로 품질을 미리 예측하여 전수 검사의 효과를 발휘
- Edge Computing의 필요성:
- 분석 결과가 설비 제어(PLC 등)로 실시간 피드백되어야 하므로,
- 클라우드 분석뿐만 아니라 현장(Edge)에서의 실시간 추론(Inference) 특성이 강조됨
5.일반 비즈니스 데이터 vs 제조 데이터
| 비교 항목 | 일반 비즈니스 데이터 | 제조 데이터 (Smart Factory) |
|---|---|---|
| 주요 데이터 형태 | 트랜잭션(로그, 구매 이력), 텍스트 | 다변량 시계열, 고주파 센서 데이터, 이미지(비전 검사) |
| 이상치(Outlier) | 노이즈로 보고 제거하는 경우가 많음 | 가장 핵심적인 분석 대상 (고장/불량의 징후) |
| 핵심 당면 과제 | 고객 행동 예측, 추천 시스템 | 예지 보전(PdM), 품질 예측, 공정 최적화 |
| 결정적 역량 | 데이터 사이언스 + 비즈니스 감각 | 데이터 사이언스 + 물리적 도메인/설비 지식 |
- 제조 데이터 유형과 특징에서 제조 데이터의 독특한 물리적·시계열적 특성을 반영했다면
- 제조 데이터의 구조 이해에서는
- 단순히 테이블의 스키마를 보는 것을 넘어
- 현장의 물리적 설비와 신호가 어떻게 디지털 데이터의 형태로 구조화되고 정렬되는가?에 초점을 맞출 것
6. 제조 데이터의 구조
6.1 수집 계층에 따른 데이터 구조
- ISA-95 프레임워크(Framework = 전체 체계)
- 국제자동화학회(ISA)에서 제정한
- 기업 IT 시스템(ERP/CRP)과 현장 제어 시스템(MES/PLC) 간의 인터페이스 및 데이터통합 전체 국제 표준 체계
- 포함 범위:
- 계층 구조(피라미드)뿐만 아니라,
- 공정 정보 모델, 자재/장비/인력 데이터 구조, 시스템 간 데이터 교환 포맷, 용어 정의 전체를 다룸
- 존재 이유:
- Siemens 설비, SAP ERP, 자체 개발 MES가 서로 대화(데이터 통합)할 수 있도록 만드는 표준 규격서
- Siemens 설비, SAP ERP, 자체 개발 MES가 서로 대화(데이터 통합)할 수 있도록 만드는 표준 규격서
- ISA-95 피라미드 모델 (Functional Hierarchy Model = 계층 구조)
- ISA-95 프레임워크 안에 포함된 여러 표준 모델 중
- 가장 유명하고 직관적인 ‘기능적 계층 구조’를 시각화한 5단계 피라미드
단계 의미 현장 내용 Level 0 물리적 공정 (Physical Process) 실제 가공/조립되는 제품 및 하드웨어 장치 Level 1 기본 제어 (Basic Control) 센서, 액추에이터, PLC, DCS (실시간 제어 및 신호 발생) Level 2 공정 감독 제어 (Supervisory Control) SCADA, HMI, 현장 Edge (설비 모니터링, 감독 및 데이터 1차 수집) Level 3 제조 운영 관리 (Manifacturing Operations Management, MOM) MES, POP, WMS (제조 실행, 스케줄링 및 현장 관리) Level 4 기업 기획 및 물류 관리 (Business Planning & Logistics) ERP, SCM (기업 자원 관리 및 비즈니스 기획) - 도표 해설
- 데이터는 아래(Level 0)에서 위(Level 4)로 올라갈수록 ‘단순 신호’에서 ‘의미 있는 정보(맥락)’로 변환됨
- 하부 계층 (Level 0~2 - Raw Data / OT 영역):
- 특징: 고주파(ms 단위), 대용량, 단순 수치(Numeric), 시계열(Time-Series) 중심
- 상태: 숫자만 늘어서 있어 이 값이 무언가를 뜻하는지 단독으로는 알기 어려움 (예: 45.2)
- 상부 계층 (Level 3~4 - Contextualized Data / IT 영역):
- 특징: 이벤트 중심(Event-driven), 관계형(Relational), 요약/집계(Summary) 중심
- 상태: 맥락이 입혀짐 (예: 45.2라는 숫자가 사출기 1호기의 노즐 온도라는 의미를 가짐)
- 공장 자동화 표준인 ISA-95 피라미드 모델을 기반으로 하는 데이터의 흐름과 계층 확인하기
- 제조 데이터의 구조를 이해하는 가장 클래식하면서도 강력한 방법
- 데이터가 상위 계층으로 올라갈수록 집계(Aggregation)되고 컨텍스트가 풍부해짐
- 제조 AI 분석의 핵심: 계층 간 데이터 융합 (Data Join)
- “AI 분석이 실패하는 이유”와 연결하기 좋은 포인트
- 센서 데이터만 있는 경우 (Level 1만 활용):
- 센서 수치가 갑자기 튀는 것은 알 수 있지만,
- “이게 원자재(Lot) 때문인지, 작업자 조작 실수인지, 설비 노후화 때문인지” 원인을 규명할 수 없음
- MES 데이터만 있는 경우 (Level 3만 활용):
- 불량이 5개 났다는 결과는 알지만,
- “공정 진행 중 설비의 전압이나 압력이 정확히 어떤 순간에 어떻게 변했는지” 미시적 원인을 알 수 없음
- 💡 결론:
- 제조 데이터 분석의 핵심은 Level 1의 시계열 센서 데이터와 Level 3의 MES 공정 이벤트(작업지시서, Lot 번호, 작업자 등)를
- Timestamp나 Lot ID 기준으로 조인(Join)하여 데이터 마트를 구축하는 것
- ISA-95 피라미드는 단순한 장비 배치도가 아니라 바로 ‘데이터가 익어가는 과정’
- 데이터 파이프라인 설계를 위해서는
- 센서가 뿜어내는 ‘의미 없는 숫자(Level 1)’에 MES의 ‘작업 맥락(Level 3)’을 입히고, ERP의 ‘비즈니스 가치(Level 4)’로 환산하는
- 전체 흐름을 이해해야 제대로 된 제조 데이터 파이프라인을 설계할 수 있음
- 분석을 위해서는
- Level 1~2의 센서 데이터와 Level 3의 MES 이벤트 데이터(예: 이 센서 값이 튄 시점에 어떤 작업지시서와 제품이 흘러가고 있었는가?)를 결합하는
- ‘계층 간 데이터 매핑 구조’를 이해하는 것이 핵심
6.2 시계열 Tag 데이터 구조
- 일반 데이터 vs 시계열 Tag 데이터
- 일반 RDBMS 방식 (Wide Table):
- 설비 1대의 여러 센서 값을 한 행에 저장
- 문제점: 센서가 추가될 때마다 테이블 컬럼을 늘려야 함 (스키마 변경 부담)
Timestamp 설비ID 온도 센서 압력 센서 진동 센서 ... 10:00:01 Unit01 230.5 5.2 0.01 ... - 시계열 Tag 데이터 방식 (Narrow Table):
- 시간과 Tag ID를 키(Key)로 하여 수직으로 저장
- 장점: 센서가 1개든 1,000개든 스키마 변경 없이 데이터 적재 가능.
Timestamp(시간) Tag ID (이름) Value (값) 10:00:01 U1_TEMP 230.5 10:00:01 U1_PRES 5.2 10:00:01 U1_VIB 0.01 10:00:02 U1_TEMP 230.7
- 일반 RDBMS 방식 (Wide Table):
- 기본 3요소 + 1요소 구조:
- Timestamp (언제?):
- 데이터가 발생한 정확한 시각 (고주파 데이터일수록 나노초/밀리초 단위 정밀도 구조)
- 단순히 시간이 아니라, 데이터의 고유 키(Primary Key) 역할을 수행함
- 도입 포인트:
- 고주파 센서(진동, 전류)는 \(ms\)(밀리초) 또는 \(\mu s\)(마이크로초) 단위까지 저장해야 오탐을 줄일 수 있음
- Tag Name/ID (무엇을?):
- 설비 및 센서의 고유 식별자
- 어떤 설비의 어떤 부위인지 식별하는 고유 코드 (예:
LINE1_MOLD_TEMP_01)
- 어떤 설비의 어떤 부위인지 식별하는 고유 코드 (예:
- 도입 포인트:
- 현장마다 Tag 명명 규칙(Naming Convention)이 다름
- 이를 표준화하는 작업이 분석 전처리에서 가장 중요함
- 설비 및 센서의 고유 식별자
- Value (값은?):
- 실제 측정값 (정수, 실수 등)과 측정된 데이터 타입
- 도입 포인트:
- 데이터 타입(Integer, Float, Boolean 등)에 따라 저장 용량과 분석 알고리즘이 달라짐
- (+추가) Quality / Flag (믿을 수 있는가?):
- 실제 현장 데이터에는 센서 고장, 통신 단절 등으로 인한 노이즈가 많음
- 데이터가 ‘정상’적으로 수집되었는지 표시하는 Quality 값(Good/Bad/Uncertain)이나 Flag 데이터가 이 구조에 함께 저장되어야 함
- Timestamp (언제?):
- 설비 메타데이터 구조 (Asset Framework):
- Tag ID 하나만 보면 이것이 어느 공장, 어느 라인, 어떤 설비의 부품인지 알 수 없음
-
설비를 트리(Tree)나 그래픽(Graph) 형태의 계층 구조로 추상화하여 Tag와 매핑하는 데이터 구조를 다루어야 함
- [메타데이터 결합] Asset Framework의 실체
- Tag ID의 한계:
LINE1_MOLD_TEMP_01🡪 분석가는 이 Tag가 속한 공장의 목표 생산량이나, 이 금형의 정비 이력을 알 수 없음- “이 금형이 언제 설치되었지?”, “이 라인의 목표 생산량은 얼마지?”라는 비즈니스적/물리적 맥락을 알 수 없음
- 해결책:
- 이 Tag ID를 실제 물리적 자산(Asset)인 ‘사출성형기 #01’에 연결하고,
- 그 자산에 대한 메타데이터(제조사, 설치일 등)를 트리 구조로 관리해야 함
- Asset Framework (가산 체계) 매핑:
-
Tag ID(가상)와 실제 물리적 자산(Asset)을 계층형 구조로 연결하고, 각 레벨에 속성(Attribute) 데이터를 부여함
  # Asset Framework 예시 (YAML 형식 트리)
  Factory: 안산공장
  Line: 가공1라인   #
      Asset: 사출성형기
      Attributes:
          Manufacturer: Sumitomo
          Install_Date: 2020-01-01
      Sensors (Tags):
          - Name: 노즐 온도 ➔ Mapping to Tag ID: LINE1_MOLD_TEMP_01
          - Name: 사출 압력 ➔ Mapping to Tag ID: LINE1_MOLD_PRES_01
-
- Tag ID의 한계:
- Time-Series DB (TSDB)의 필요성
- 그렇다면 이 방대한 시계열 데이터는 어디에 저장하는가?
- 거대한 시계열 데이터를 처리하기 위해 RDBMS가 아닌 ‘TSDB(시계열 데이터베이스)’라는 전용 저장소가 필요함
- “어? 그냥 3개 컬럼짜리 테이블이면 우리가 흔히 쓰는 MySQL/Oracle 같은 RDBMS나 엑셀에 저장해도 되는 것 아닌가요?”
- “어? 그냥 3개 컬럼짜리 테이블이면 우리가 흔히 쓰는 MySQL/Oracle 같은 RDBMS나 엑셀에 저장해도 되는 것 아닌가요?”
- 거대한 시계열 데이터를 처리하기 위해 RDBMS가 아닌 ‘TSDB(시계열 데이터베이스)’라는 전용 저장소가 필요함
-
TSDB vs RDBMS
비교 항목 시계열 전용 DB (TSDB) 전통적 관계형 DB (RDBMS) 주요 목적 고주파 시계열 데이터의 초고속 적재 및 연속 추이 분석 복잡한 관계형 트랜잭션의 정확성 및 무결성 보장 쓰기 성능 Append-only(누적 저장) 위주의 초고속 쓰기
(초당 수십만 건 수신 가능)트랜잭션 Lock 및 인덱스 갱신으로 초고속/대용량 쓰기에 한계 데이터 수정/삭제 거의 발생하지 않음 (과거 기록은 불변) UPDATE / DELETE 작업이 빈번하게 발생 저장 효율성 동일한 Tag ID 반복 구조에 최적화된 고압축률 (용량 80~90% 절감) 데이터 가변성으로 인해 압축 효율이 낮고 용량 급증 조회 및 분석 (Query) 시간 범위 집계(평균, 이동평균, Downsampling)에 특화된 전용 함수 제공 시간 단위 그룹화/집계 시 쿼리가 매우 복잡하고 속도가 현저히 느림 - 대조 항목별 세부 설명
- 쓰기 성능 (Insert Speed): ‘누적’ vs ‘무결성’
- RDBMS의 한계:
- RDBMS는 데이터의 ACID(트랜잭션 무결성)를 보장하기 위해 데이터를 쓸 때마다 Index를 갱신하고 테이블에 Lock을 적용
- 밀리초($ms$) 단위로 센서 수만 개가 뿜어져 나오는 상황에서는 DB에 병목(Overhead)이 생겨 데이터가 유실될 수 있음
- TSDB의 강점:
- 과거 데이터를 수정하지 않는 ‘Append-only(단순 누적)’ 방식을 채택
- 인덱싱 부담을 최소화하고 쏟아지는 데이터를 스폰지처럼 주입
- RDBMS의 한계:
- 저장 공간과 압축 (Storage & Compression): ‘패턴 압축’ vs ‘일반 저장’
- RDBMS의 한계:
- Timestamp, Tag ID 같은 동일한 텍스트 데이터가 매초/매밀리초마다 무한 반복 저장
- 디스크 용량이 순식간에 소모됨
- TSDB의 강점:
- “어차피 Tag ID는 계속 똑같고, Timestamp는 1초씩 일정하게 증가한다”는 특성을 이용
- 차이값(Delta)만 저장하는 시계열 특화 압축 알고리즘(Gorilla 등)을 사용 🡪 용량을 1/10 수준으로 감소
- RDBMS의 한계:
- 조회 및 집계 쿼리 (Querying & Aggregation): ‘전용 함수’ vs ‘복잡한 SQL’
- RDBMS의 한계:
-“최근 1시간 동안의 1분 단위 평균값”을 구하려면 GROUP BY와 시간 변환 함수를 복잡하게 조합해야 함
- 수억 건의 레코드를 스캔하느라 조회 시간이 수십 초 이상 소요
- TSDB의 강점:
- time_bucket(), moving_average() 같은 시계열 전용 함수를 기본 제공
- 미리 집계된 데이터(Downsampling) 구조가 적용되어 있음
- 수억 건의 데이터도 0.1초 만에 그래프로 출력 가능
- RDBMS의 한계:
-“최근 1시간 동안의 1분 단위 평균값”을 구하려면 GROUP BY와 시간 변환 함수를 복잡하게 조합해야 함
- 쓰기 성능 (Insert Speed): ‘누적’ vs ‘무결성’
- 대조 항목별 세부 설명
- 시계열 Tag 데이터 구조를 이해한다는 것은 단순히 Timestamp, Tag, Value라는 세 단어를 아는 것이 아님
- 쏟아지는 센서 신호를 유실 없이 저장하고(TSDB),
- 그 숫자가 어느 공장, 어느 설비의 것인지 맥락(Asset Framework)을 입히고,
- 그 데이터가 믿을 수 있는지(Quality Flag)까지 함께 관리하는
- 전체 체계를 이해하는 것이 제대로 된 제조 데이터 분석의 출발점
- 그렇다면 이 방대한 시계열 데이터는 어디에 저장하는가?
6.3 공정 컨텍스트 데이터 구조
- 센서 데이터가 아무리 많아도 ‘맥락(Context)’이 없으면 무의미한 숫자 나열에 불과함
-
제조 데이터 구조화의 핵심은 시계열 데이터에 공정의 맥락을 입히는 데이터 모델링
- Lot / Serial 기반 구조:
- 제품 한 단위(Unit) 또는 한 묶음(Lot)이 시각 A에 공정 1에 진입하여 시각 B에 나갔다는 시간적 구간(Interval) 데이터 구조
- 4M 데이터 구조 (Man, Machine, Material, Method):
- Man: 해당 시점에 작업한 작업자 정보
- Machine: 사용된 설비 및 금형/툴 번호
- Material: 투입된 원자재의 Lot 번호 (추적성, Traceability)
- Method: 당시 설비에 세팅된 레시피(Recipe) 및 파라미터 조건
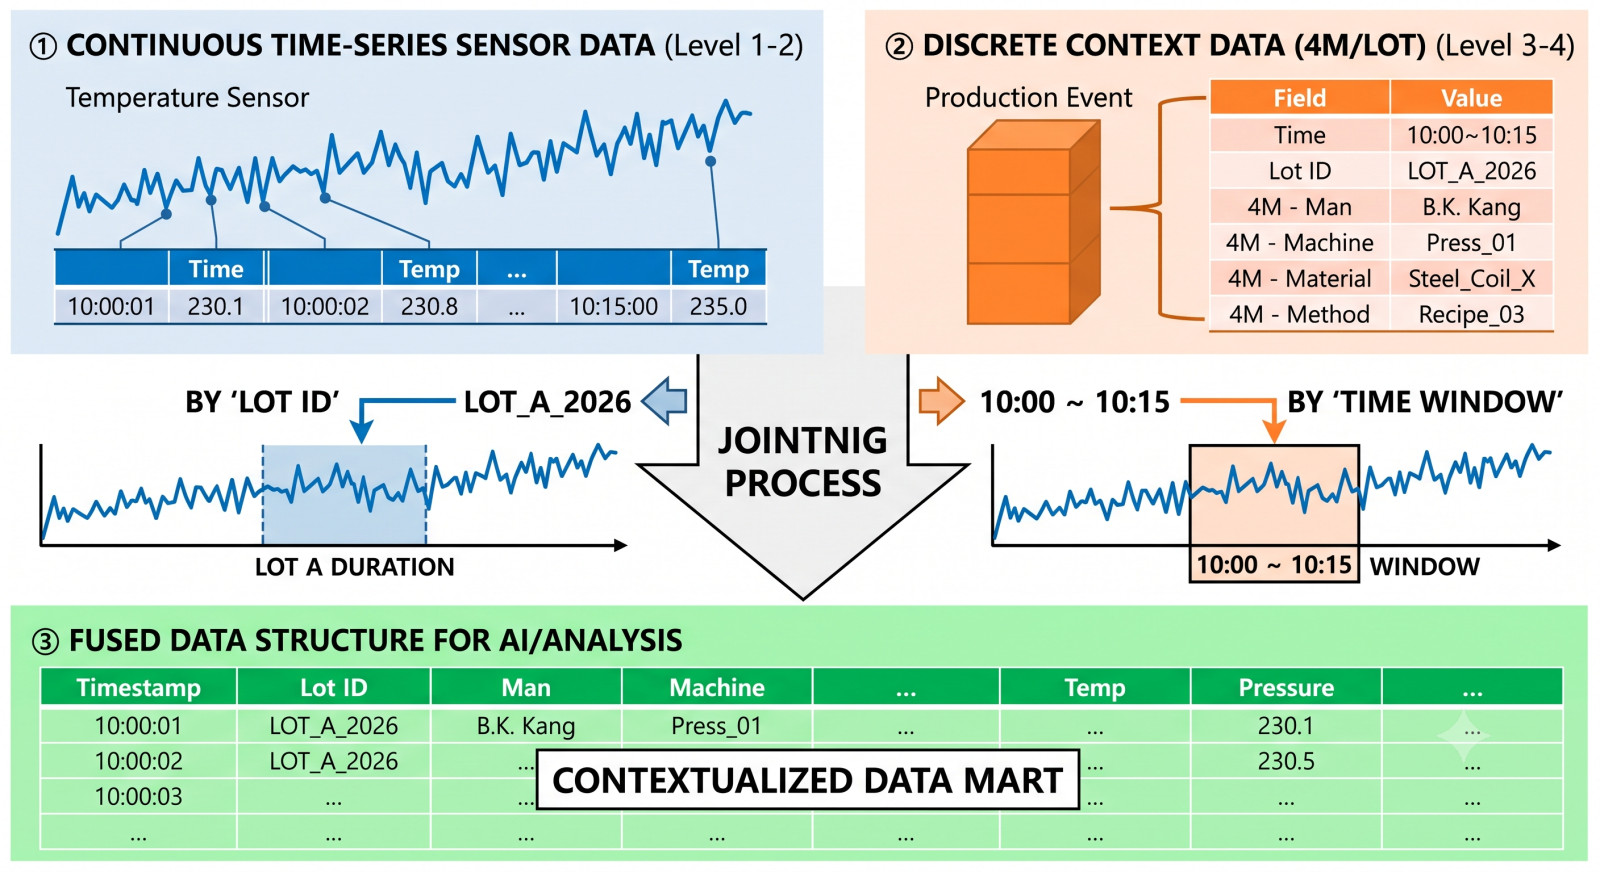 시계열 센서 데이터(Continuous)와 4M 컨텍스트 데이터(Discrete)를 특정 'Time Window(시간 창)'이나 'Lot ID'를 기준으로
어떻게 조인(Join)하고 융합 구조를 만드는지 시각적으로 보여주는 그림 (Source: SkyLectures / AiDALab)
6.4 제조 특화 데이터 포맷과 표준 프로토콜
- 통신 표준과 데이터 트리: OPC-UA (Open Platform Communications Unified Architecture)
- 개념:
- 서로 다른 제조사의 설비(Siemens, Mitsubishi 등)가 브랜드에 상관없이 동일한 언어로 대화할 수 있도록 만들어진
- 스마트팩토리 표준 통신 아키텍처
- 노드(Node)와 오브젝트(Object) 데이터 구조:
- 설비와 센서를 단순한 숫자가 아니라, 객체(Object) 중심의 트리(Tree) 구조로 추상화하여 관리
-
구조 예시:
[Root] (뿌리) └── [Objects] └── [Line1_CNC_Machine] (오브젝트: 1라인 CNC 설비) ├── [Variables] (변수 노드: 실제 측정 데이터) │ ├── Temperature: 42.5 (°C) │ └── Spindle_RPM: 1200 (RPM) └── [Methods] (메서드 노드: 제어 명령) └── Start_Cooling() (냉각기 가동 명령)- OPC-UA는 단순히 숫자를 주고받는 것이 아니라
1라인 CNC 설비라는 상자(오브젝트) 안에온도라는 변수(Node)와냉각 가동이라는 명령(Method)을- 트리 형태로 묶어서 주고받는 데이터 구조를 의미함
- 개념:
- 반도체/디스플레이 특화 구조: SECS/GEM 프로토콜
- 개념:
- 반도체/디스플레이 공정처럼 매우 정밀하고 복잡한 설비에서 표준으로 사용되는
- 장비-호스트(MES) 간 통신 규격
- 핵심 수집 데이터 구조 (SVID & 이벤트 리포트):
- SVID (Status Variable ID):
- 장비의 현재 상태를 나타내는 정적/동적 변수 번호
- 예:
SVID 1001= Chamber Temperature,SVID 1002= Gas Flow Rate
- 예:
- 장비의 현재 상태를 나타내는 정적/동적 변수 번호
- 이벤트 기반 리포트 (Event-Driven Report):
- 밀리초 단위로 데이터를 무조건 출력/전달하는 것이 아니라,
- 특정 사건(Event)이 발생했을 때 관련된 SVID 묶음을 전송하는 효율적인 구조
-
데이터 수집 예시 구조:
[Event Trigger] 🡪 "웨이퍼 가공 완료 (Event ID: 501)" 발생 시! └── [Event Report Data Package] ├── Time: 2026-03-27 10:00:00.123 ├── SVID 1001 (Chamber Temp): 250.0 °C ├── SVID 1002 (Gas Flow): 50.2 sccm └── SVID 2005 (Wafer ID): WAF_2026_09- SECS/GEM은 무작정 데이터를 쌓는 게 아니라,
웨이퍼 투입,가공 완료같은 특정 이벤트가 발생한 순간에- 해당 이벤트와 연관된 SVID(변수 값들)를 한 묶음의 리포트로 패키징해서 전송하는 데이터 구조를 가짐
- SVID (Status Variable ID):
- 개념:
- 빅데이터 저장 포맷: Columnar(컬럼 기반) 저장 구조 vs CSV
- 개념:
- 엑셀이나 CSV처럼 가로(Row) 방향으로 데이터를 저장하는 것이 아니라,
- 세로(Column) 방향으로 데이터를 모아서 저장하는 빅데이터 전용 파일 포맷(Parquet, Avro 등)
- 대규모 시계열 데이터를 분석할 때, 디스크 읽기(Disk I/O) 병목을 줄이고 분석 조회 속도를 극대화하기 위해 사용함
-
구조적 차이점 비교:
구분 일반 CSV / RDBMS (Row-based) Parquet / ORC (Columnar-based) 저장 방식 텍스트 (문자열) 바이너리 (컬럼별 인코딩 및 압축) 압축률/디스크 사용량 텍스트 형태 그대로 저장되어 용량이 큼 동일한 센서 데이터끼리 모여 있어 압축률 80~90% 달성 저장 시 CPU 소모 적음 (단순 텍스트 쓰기) 큼 (컬럼 재배치 및 압축 연산 필요) 분석 조회 속도 느림 (불필요한 컬럼까지 전체 스캔) 압도적으로 빠름 (필요한 컬럼만 디스크에서 로드)
- 개념:
