설비 수집 구조 및 데이터 연계
PLC-센서-클라우드 기반 데이터 수집 및 MES/SCADA 연계, 사업재편 설비 이전 시 발생하는 결손 문제
- 1. 제조 데이터 수집 방법
- 2. 데이터 수집 시스템 구축 통합 개요
- 3. 사업재편 및 설비 재배치 시 발생하는 4대 데이터 결손 메커니즘
- 4. 사업재편 결손 방지 및 데이터 연속성 확보 실무 프로세스 (SOP)
- 정리
1. 제조 데이터 수집 방법
1.1 데이터 수집 전 준비 사항
-
제조 현장에서 데이터를 수집하기 위해서는 먼저 체계적인 준비가 필요함
- 현장 실사
- 각 설비별로 사용하고 있는 제어장치 종류(PLC, PC, 계측기, 스캐너, Graphic Panel 등) 및 관리하고자 하는 항목을
- 인터페이스할 수 있는 제어장치의 I/O 모듈 상황을 종합적으로 파악
- 공정 및 제품 특성 파악
- 공정과 제품의 특성 분석
- 각 공정별로 표준관리 항목 결정
- 누락된 측정 항목 확인
- 기존 공정에서 누락된 측정 항목은
- 새로운 센서/계측기를 추가하여 데이터가 수집될 수 있도록 고려
1.2 데이터 수집 방법의 유형
-
제조 현장에서 데이터를 수집하는 방법은 크게 세 가지로 분류
- 자동 수집 방법
- 적용 상황
- 생산설비의 제어기가 외부 정보시스템과 연결 가능한 프로토콜을 보유한 경우
- 이더넷 등과 같은 표준 인터페이스 장치를 보유한 경우
- 구현 방식
- 실시간 통신 프로그램을 이용하여 생산설비와 연결된 제어 기기와 정보시스템 간 데이터 교환
- 장점
- 실시간 데이터 수집
- 높은 정확성
- 인적 오류 감소
- 적용 상황
- 반자동 수집 방법
- 적용 상황
- 생산설비에서 자동으로 데이터를 추출하기 어렵거나
- 일부 수동 개입이 필요한 경우
- 구현 방식
- 바코드, RFID, 터치스크린 등의 입력 장치를 활용하여 작업자가 데이터를 입력
- 장점
- 완전 수동 방식보다 효율적
- 기존 설비에도 적용 가능
- 적용 상황
- 수동 수집 방법
- 적용 상황
- 자동화된 인터페이스가 없거나
- 구축이 어려운 오래된 설비
- 구현 방식
- 작업자가 직접 데이터를 기록하고 입력
- 단점
- 데이터 입력 지연
- 인적 오류 발생 가능성 높음
- 적용 상황
1.3 데이터 수집 기술 및 장비
-
제조 현장에서 데이터를 수집하기 위해 다양한 기술과 장비가 활용됨
- IoT 센서: 온도, 습도, 압력, 진동 등 물리적 환경 데이터 수집
- PLC(Programmable Logic Controller): 생산 설비 제어 및 데이터 수집
- 스마트 계측기: 제품 품질 관련 측정 데이터 수집
- RFID/바코드: 자재 및 제품 추적 데이터 수집
- 산업용 카메라: 비전 검사 및 품질 관련 이미지 데이터 수집
- 게이트웨이 장비: 다양한 프로토콜 변환 및 데이터 전송
1.4 데이터 수집 시 주의사항
- 시간 동기화 문제
- 여러 설비에서 수집된 데이터의 시간이 동기화되지 않으면 정확한 분석이 어려울 수 있음
- 초 단위 이하의 섬세한 분석이 필요할 경우 시간 동기화가 매우 중요
- 데이터 품질 관리
- 센서 오작동, 통신 오류 등으로 인한 데이터 손실이나 오류 발생 가능성 고려
- 데이터 형식 표준화
- 다양한 설비에서 수집되는 데이터의 형식을 표준화하여
- 통합 분석이 가능하도록 해야 함
- 보안 문제
- 제조 데이터는 기업의 핵심 자산
- 수집 과정에서의 보안을 철저히 고려해야 함
2. 데이터 수집 시스템 구축 통합 개요
2.1 [수집 체계] 제조 데이터 수집 4계층
- 제조 데이터 수집은 단순히 센서를 달고 선을 뽑는 것이 아님
- 현장의 물리 신호가 클라우드/서버의 가치 있는 정보로 변환되는 4단계 계층 파이프라인으로 이해해야 함
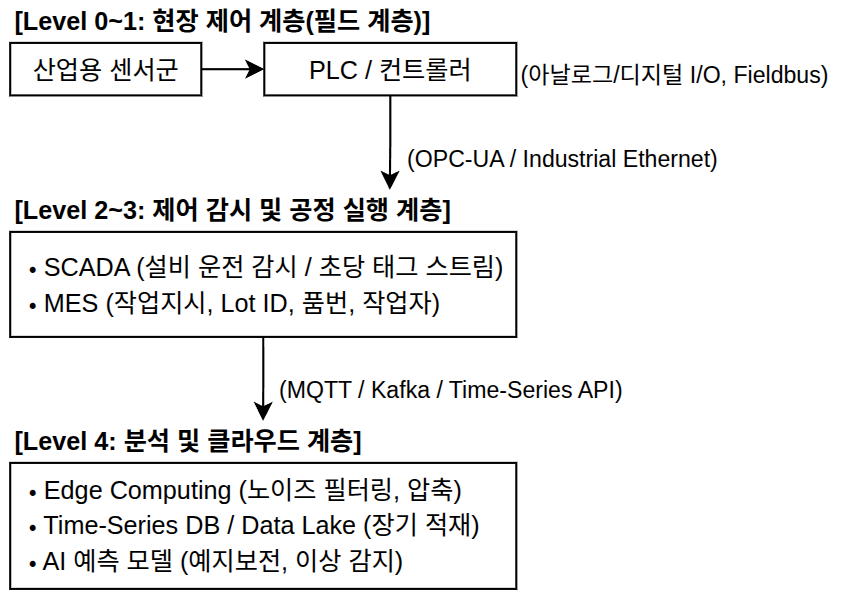
- 제조 데이터는 물리 세계(OT)의 아날로그 신호가 디지털 정보로 변환되어 상위 IT 시스템으로 집계되는 다단계 파이프라인을 거침
 (Source: Sky Lectures / AiDALab)
- Level 0-1: 현장 제어 계층(데이터 발생 계층, 필드계층)
- 계층의 역할: 원천 신호 생성 및 시퀀스 제어
- 수집 대상: 물리적 현장 신호 (온도, 진동, 압력) 및 설비 제어 메모리
- 수집 대상 장비
- 산업용 센서:
- 진동 가속도계, 열전대(온도), 압력 트랜스미터, 로드셀(하중), 유량계 등 공정 상태를
- 전압($0 \sim 10\text{V}$) 또는 전류($4 \sim 20\text{mA}$) 형태로 출력
- PLC (Programmable Logic Controller):
- I/O 인터페이스를 통해 센서 신호를 받아 미리 작성된 래더 로직(Ladder Logic)에 따라 설비를 밀리초($\text{ms}$) 단위로 직접 제어
- 메모리 레지스터(D영역, M영역, %MW 등)에 입출력 상태를 기록
- 설계상 특성:
- 제어 안정성과 실시간성이 절대적 우선순위이므로,
- 내부 메모리 용량이 한정적이며 수개월 치 과거 이력이나 품목 메타데이터를 저장하지 못함
- 산업용 센서:
- 수집 방식의 결정 (설비 환경별 3원칙):
- 전동화/지능화 설비 (Smart Equipment): 이더넷/표준 통신 기반 자동 수집 (PLC, Controller 직결)
- 반자동/과도기 설비 (Legacy with Interface): 작업자 개입형 반자동 수집 (바코드, HMI, POP 터치스크린)
- 아날로그 레거시 설비 (Old Legacy): 신규 IoT 센서(진동, 전류) 후가공 부착 또는 작업자 수동 일지 입력
- Level 2~3: 엣지 및 게이트웨이 계층 (Edge & Protocol Gateway)
- 이종(異種) 프로토콜 변환:
- 설비별 폐쇄적 프로토콜(MELSEC, Modbus, Siemens MPI)을 경량 표준 규격(OPC UA, MQTT)으로 단일화(통합 변환)
- 엣지 전처리 (Edge Preprocessing):
- 초고주파 진동(수 $\text{kHz} \sim \text{tens of kHz}$) 데이터를 전부 클라우드로 올리면 네트워크 비용과 병목이 발생
- 엣지단에서 RMS, Peak-to-Peak, Kurtosis 등의 주파수 지표로 1차 압축 및 요약
- 불필요한 정상 데이터 반복 전송을 줄이는 데드밴드(Deadband) 필터링을 통해 대역폭을 최대 70% 이상 절감
- 무결성 보장 (Store & Forward):
- 공장 내부망 또는 인터넷 회선 장애 시, 엣지 장비의 로컬 SSD에 데이터를 임시 저장한 후 통신 복구 시 누락 없이 재전송(데이터 유실 방지)
- 공장 내부망 또는 인터넷 회선 장애 시, 엣지 장비의 로컬 SSD에 데이터를 임시 저장한 후 통신 복구 시 누락 없이 재전송(데이터 유실 방지)
- 참고: SCADA와 MES의 연계: 물리 시계열과 제조 문맥(Context)의 통합
- 설비 센서 데이터(SCADA)와 공정 운영 이력(MES)은 상호 독립적으로 수집되지만 AI 기반 분석을 위해서는 반드시 시간축을 중심으로 결합되어야 함
구분 SCADA (설비 모니터링/제어 MES (제조 실행/운영) 데이터 본질 설비 중심의 연속 시계열 물리량 제품 중심의 불연속 트랜잭션/이벤트 수집 주기 수십 $\text{ms} \sim$ 초 단위 (상시 연속 수집) 공정 시작/종료, Lot 투입/배출 시점 (이벤트 기반) 대표 데이터 모터 전류값, 가열로 온도, 사출 압력, 사이클 타임 작업지시 번호, Lot 번호, 품번, 작업자 ID, 금형 번호, 양품/불량 판정 단독 사용의 한계 이상 신호는 감지되나, 어떤 제품을 가공 중이었는지 모름 불량 발생 결과는 집계되나, 가공 당시 물리적 원인 파악 불가
- 이종(異種) 프로토콜 변환:
- Level 4: 클라우드 및 데이터 레이크 계층(데이터 적재 및 맥락화)
- 시계열 & 컨텍스트 결합:
- TSDB(센서 데이터) + MES/ERP(4M / Lot ID / 작업지시서) 결합
- 시계열 데이터베이스(TSDB): InfluxDB, TimescaleDB, AWS Timestream 등에 시간 인덱스($t$)를 기반으로 대규모 로그를 분산 적재함
- TSDB(센서 데이터) + MES/ERP(4M / Lot ID / 작업지시서) 결합
- 데이터 품질 제어 (Quality Flag):
- 수집 시점에 데이터의 신뢰성(Good/Bad/Uncertain) 및 시간 동기화(NTP Sync) 검증
- AI/ML 파이프라인 연계:
- 축적된 시계열 데이터와 라벨 정보를 바탕으로 잔여수명 예측(RUL), 설비 이상 탐지(Anomaly Detection), 파라미터 최적화 모델을 훈련 및 추론
- 시계열 & 컨텍스트 결합:
2.2 [품질/준비 체계] 구축 표준화 프레임워크
-
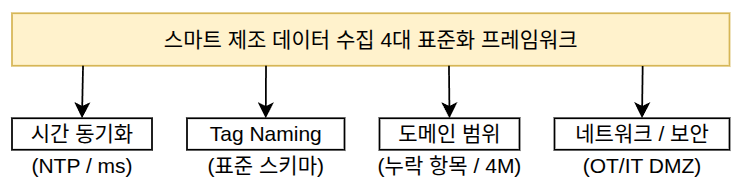
수집 시스템을 구축할 때 마구잡이식 도입을 막기 위해 반드시 검토해야 하는 4가지 수직적 체크리스트
 (Source: Sky Lectures / AiDALab)
- 시간 동기화 (Time Synchronization) 체계:
- 원칙: 전사 설비/PLC/서버의 시각을 NTP(Network Time Protocol) 서버 기준으로 밀리초($ms$) 단위 일치
- 이유: 시간 축이 틀어지면 A 설비의 압력 상승과 B 설비의 불량 발생 간 인과관계를 추적 불가능
- Tag Naming 표준화 체계:
- 원칙:
[공장코드]_[라인]_[설비]_[부위]_[데이터타입]식별자 체계 정립 (예:AS_L1_PRESS01_TEMP_01) - 이유: 표준화가 안 되면 데이터 분석 전처리 단계에서 80% 이상의 시간이 소비됨
- 원칙:
- 공정 맥락(Context) 완전성 체계:
- 원칙: 센서 수치(Value) 외에 4M(Man, Machine, Material, Method) 및 Lot ID 누락 여부 사전 실사
- OT-IT 망 분리 및 보안 체계:
- 원칙: 공장 제어망(OT)과 데이터 분석망(IT) 사이에 산업용 DMZ 게이트웨이 배치 (단방향 데이터 전송)
- 시간 동기화 (Time Synchronization) 체계:
2.3 [분석 체계] 제조 데이터 분석의 가치 사슬
- 단순히 “EDA를 하고 모델링을 한다”는 단계 방식 대신,
-
“분석의 수준이 올라갈수록 현장에 어떤 가치를 주는가?”라는 가치 지향적 분석 체계로 다룸
분석 단계 분석 질문 핵심 기술 및 접근법 현장 적용 예시 (Outcome) 1단계: 현상 파악 지금 공장에 무슨 일이 일어났는가? 시계열 대시보드, SPC(통계적 공정제어), EDA 설비 가동률 모니터링, 실시간 온·습도 알람 2단계: 원인 진단 왜 이런 불량/고장이 발생했는가? 다변량 상관관계 분석, Root-Cause Analysis, XAI 3번 노즐 온도 2℃ 상승 시 불량률 15% 증가 규명 3단계: 미래 예측 앞으로 언제 고장이 날 것인가? 이상 탐지(Anomaly Detection), 머신러닝/딥러닝 예지 보전(PdM): 2번 베어링 72시간 내 고장 확률 90% 4단계: 자율 처방 최적의 품질을 위해 어떻게 제어해야 하는가? 최적화 알고리즘, 강화학습/Simulation 가상 계측 및 폐루프제어: AI가 PLC에 최적 가공 조건 자동 전달
2.4 [분석 체계] 제조 AI 프로젝트 수행 단계
-
일반적인 CRISP-DM 방법론을 제조 도메인 특성에 맞게 재정의한 실무 프로세스
- [1단계] 현장 문제 및 페인포인트(Pain Point) 정의:
- 단순히 “AI 분석”이 아닌, “사출 불량률 2% ➔ 0.5% 절감”과 같은 확실한 목적 및 ROI 설정
- [2단계] 도메인 지식 기반 데이터 맵핑 (Domain Mapping):
- 현장 베테랑 작업자의 노하우를 바탕으로 분석에 필요한 4M 데이터 항목 식별
- [3단계] 제조 특화 데이터 전처리 (Data Preprocessing):
- 결측치: 단순히 평균값으로 채우지 않고, 설비 비가동(OFF) 상태인지 센서 오류인지 구분하여 처리
- 이상치: 통계적 이상치와 물리적 한계치(Spec Limit)를 구분하여 노이즈 제거
- [4단계] 클래스 불균형 극복 및 이상 탐지 모델링:
- 99.9% 양품 데이터 특성을 고려해 One-Class Classification(Isolation Forest, Autoencoder) 중심 모델링
- [5단계] 현장 전문가(Domain Expert) 검증:
- AI의 예측 결과가 물리·화학적 인과관계(Causality)에 부합하는지 베테랑 엔지니어와 복기
- [6단계] MLOps 기반 현장 배포 및 지속적 재학습:
- Edge/Cloud 배포 후, 계절성(Seasonality) 및 설비 마모에 대응하는 Model Drift 감지 체계 운용
- [1단계] 현장 문제 및 페인포인트(Pain Point) 정의:
3. 사업재편 및 설비 재배치 시 발생하는 4대 데이터 결손 메커니즘
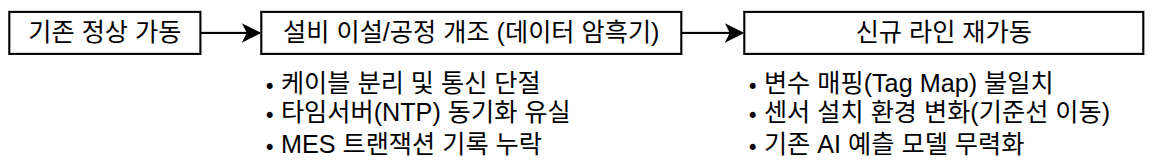
- 사업재편(라인 통합, 유휴 설비 이설, 공정 재배치, 신규 자동화기기 결합) 시
- 물리적 설비 이동에만 집중하고 데이터 파이프라인 설계를 간과하면,
-
장기간 수집된 데이터의 가치가 파괴됨
 (Source: Sky Lectures / AiDALab)
- 결손 원인 1: 물리적 단절로 인한 장시간 공백 (Data Gap)
- 설비 분해, 포장, 운송, 재설치, 배선 작업 기간 동안 계측이 전면 중단됨
- 영향:
- 계절성 추세나 점진적 설비 열화를 학습하던 시계열 AI 모델(LSTM, AutoEncoder 등)에 연속성 단절을 초래
- 재가동 직후 대규모 오탐지를 유발함
- 결손 원인 2: PLC 어드레스 변경 및 태그 맵(Tag Map) 오매핑
- 이설 후 배선 재작업 및 PLC 프로그램 수정 과정에서
- 기존 메모리 번지(예:
%MW100이 기존 ‘주축 온도’에서 ‘유압 압력’으로 변경)가 변경되는 경우가 다수 발생 - 영향:
- 하청사나 설비 제작업체 간 변수 명명 체계가 달라져
- 기존 컬럼에 엉뚱한 센서 값이 덮어써지는 데이터 오염(Data Corruption) 발생
- 결손 원인 3: 타임스탬프 동기화 유실 (Clock Drift)
- 분리된 독립 설비의 PLC 내부 RTC(Real-Time Clock) 배터리가 방전되거나,
- 신규 공장 네트워크에서 사내 NTP(Network Time Protocol) 서버 설정이 누락됨
- 영향:
- 1번 공정과 2번 공정의 타임스탬프가 수초에서 수십 분 이상 어긋남
- 심한 경우 후공정 완료 시간이 전공정 시작 시간보다 앞서는 시간 역전 현상이 발생
- 인과관계 분석이 불가능해짐
- 결손 원인 4: 물리 환경 변화에 따른 기준선 이동 (Covariate Shift)
- 설비 위치 변경, 바닥 진동 기초(Base) 변경, 센서 탈부착 각도 오차, 배관 경로 변경 등으로 인해
- 설비 상태는 정상이지만 센서 계측의 평균값과 노이즈 수준이 영구적으로 달라짐
- 영향:
- 기존에 설정된 정상 데이터의 통계적 분포($P(X)$)가 변하여,
- 과거 데이터로 학습된 머신러닝 이상 탐지 알고리즘이 지속적인 허위 경보(False Alarm)를 발생시킴
4. 사업재편 결손 방지 및 데이터 연속성 확보 실무 프로세스 (SOP)
-
설비 이전 프로젝트 단계별로 데이터 무결성을 보장하기 위한 표준 운영 절차
- 1단계: [이설 전] 벤치마크 데이터 동결 및 스냅샷 확보
- 설비 가동 중단 직전, 최소 30일 이상의 정상 운전 시계열 데이터와 MES 실적 데이터를 동결(Freeze) 백업
- 주요 센서별 정상 통계량(평균 $\mu$, 표준편차 $\sigma$, 상관계수 행렬, 진동 FFT 스펙트럼)을 기준 벤치마크 리포트로 문서화
- 2단계: [설계 단계] 표준 태그 딕셔너리(Tag Dictionary) 수립
- 신규 라인 배치도에 맞추어 표준화된 자산 식별 체계(Asset Naming Convention)를 확정
- 예:
[사업장]_[라인코드]_[공정번호]_[설비구분]_[센서종류](UL_LINE02_ST03_PRESS_TEMP01)
- 예:
- 설비 시공 전, PLC 주소와 DB 수집 컬럼 간 1:1 매핑 테이블을 작성하고 검증 승인을 완료함
- 신규 라인 배치도에 맞추어 표준화된 자산 식별 체계(Asset Naming Convention)를 확정
- 3단계: [재시운전 단계] 통신 및 시각 동기화 전수 검증
- 통신 개통 즉시 전 공정 장비의 NTP 시각 동기화 오차를 $\pm 1\text{ms}$ 이내로 조정
- 무부하 시운전 상태에서 ‘더미 데이터(Dummy Data)’를 생성하여, MES 작업 지시 시점과 SCADA 수집 패킷 간 시각 일치 여부를 대조
- 4단계: [재가동 이후] 결측치 보정 및 AI 모델 재보정(Calibration)
- 단기 결측치(수초 ~ 수분 내 일시적 드롭):
- 선형 보간(Linear) 또는 스플라인(Spline) 보간법을 적용하되,
- 분석 시 왜곡을 방지하기 위해 해당 데이터 레코드에 반드시 결측 보정 플래그(
Flag = IMPUTED)를 기록
- 장기 공백(수일 이상의 이설 기간):
- 결측 구간을 인위적으로 채우지 않고,
- 이설 시점을 기준으로 데이터셋 버전(Version Partition)을 명확히 분리
- AI 모델 기준선 갱신:
- 재배치 후 최소 1~2주간의 신규 안정화 데이터를 확보한 후,
- 전이 학습(Transfer Learning) 또는 기준선 재조정(Baseline Calibration)을 수행하여 모델을 현행화
- 단기 결측치(수초 ~ 수분 내 일시적 드롭):
정리
- 제조 기업이 신사업 진출이나 생산 효율화를 위해 사업재편(공정 재배치, 신규 라인 증설, 노후 설비 개체)을 추진할 때,
- 가장 흔하게 직면하는 실패 원인은 설비 설치 자체가 아닌 데이터 파이프라인의 단절과 정합성 왜곡
- 데이터 수집의 목적은 제어와 분석의 양립:
- PLC는 실시간 제어를 수행하고 MES는 제조 문맥을 부여하며,
- 이 둘이 엣지/클라우드에서 결합될 때만 온전한 제조 AI 데이터가 완성됨
- 사업재편 시 설비 이전은 단순 기계 이동이 아님:
- 통신 단절, 태그 맵 변조, 타임스탬프 오류, 센서 기준치 이동 등 정합성을 무너뜨리는 4대 결손 요인을 사전에 통제해야 함
- 사전 준비가 재작업을 방지:
- 이설 전 30일 벤치마크 확보, 표준 태그 딕셔너리 정의, NTP 전수 검증이라는 3가지 원칙을 지키는 것이
- 데이터 분석 파이프라인의 조기 정상화를 보장함
