(실습) 노코드 기반 예측 모델 구축
노코드 AI 도구를 활용해 사업재편 공정의 불량 유무 및 수율 예측 모델 생성 및 결과 해석
1. 실습 개요 및 실습 목표
- 실습 개요
- 오픈소스 기반 대표 노코드 데이터 분석 도구인 Orange 3(오렌지 3)를 활용하여,
- 복잡한 파이썬 코딩 없이 GUI 드래그 앤 드롭 방식으로
- 제조 공정 데이터를 탐색하고 머신러닝 예측 모델을 구축·평가함
- 실습 내용
- 사업재편에 따라 새롭게 도입된 생산 라인에서 설비 세팅값과 원자재 물성 데이터를 기반으로
- ‘불량 발생 여부(분류: Pass/Fail)’ 및 ‘공정 수율(회귀: Yield %)’을 사전에 예측하고,
- 모델의 변수 중요도(Feature Importance)를 해석하여
- 실제 설비 운영 파라미터를 역으로 최적화하는 전 과정을 수행함
- 실습 목표
- 노코드 워크플로우 숙달:
- Orange 3의 기본 위젯(Data, Model, Evaluate, Visualize) 간 데이터 연결 구조를 이해하고
- 파이프라인을 직접 설계할 수 있음
- 타깃별 예측 모델 동시 구축:
- 분류(Classification):
- 이진 분류 모델(Random Forest, Logistic Regression, Tree)을 통해 불량품(Fail)을 조기에 걸러내는 모델을 구축하고
- ROC/AUC 및 Recall(재현율)을 평가할 수 있음
- 회귀(Regression):
- 수치 예측 모델(Linear Regression, Random Forest Regressor)을 통해 공정 수율(%)을 추정하고
- RMSE 및 $R^2$ 점수를 해석할 수 있음
- 분류(Classification):
- 결과 해석 및 공정 최적화 연계:
- 모델이 도출한 변수 중요도 및 결정 트리 규칙을 바탕으로
- “어떤 공정 조건을 제어해야 불량을 최소화할 수 있는지” 데이터 기반 액션 플랜을 도출할 수 있음
- 노코드 워크플로우 숙달:
2. 실습 시나리오
- [상황 설정] 친환경 배터리 팩 알루미늄 케이스 신규 라인 전환
- A사는 기존 내연기관 부품 라인을 축소하고, 신규 전기차용 알루미늄 배터리 팩 하우징 정밀 프레스·열처리 공정으로 사업재편을 단행하였음
- 현장의 문제:
- 신규 알루미늄 합금(6000계열)은 기존 강판 대비 열팽창률이 높고 연신율이 민감하여,
- 초기 가동 시 크랙 및 미성형 결함으로 인해 수율이 78%에 머물며
- 막대한 소재 스크랩 손실이 발생하고 있음
- 목표 과제:
- 설비 가열 온도, 성형 압력, 냉각 속도, 원소재 인장강도 데이터를 기반으로 해당 배치가 불량(Fail)인지 사전 판별
- 최종 수율(Yield, %)을 90% 이상으로 유지하기 위한 최적의 공정 파라미터 조합 기준을 도출
3. 실습 데이터셋 구조 및 생성 파이썬 코드
-
데이터셋 스펙 (총 1,200개 배치 데이터)
컬럼명 데이터 타입 Orange 역할(Role) 설명 및 물리적 범위 batch_id Text Meta 생산 배치 고유 번호 (예: LOT_0001) raw_tensile_strength Numeric Feature 원자재 인장강도 (MPa, 범위: 240 ~ 320) raw_thickness Numeric Feature 원자재 두께 (mm, 표준 2.0mm, 범위: 1.85 ~ 2.15) press_pressure Numeric Feature 프레스 성형 압력 (ton, 범위: 120 ~ 200) die_temp Numeric Feature 금형 가열 온도 (℃, 범위: 180 ~ 260) cool_rate Numeric Feature 급랭 냉각 속도 (℃/s, 범위: 10 ~ 35) operator_shift Categorical Feature 작업 조 (Day, Evening, Night) yield_rate Numeric Target (회귀) 공정 수율 (%, 범위: 65.0 ~ 99.5) quality_status Categorical Target (분류) 최종 품질 판정 ( Pass: 수율 90% 이상,Fail: 90% 미만)
- 데이터 생성 파이썬 코드
- 실습용 CSV 파일을 자동으로 생성하는 코드
- 실제 제조 현장의 비선형적 물리 특성(과열 및 압력 부족 시 급격한 불량 증가 등)이 반영되어 있음
-
💾 파일 다운로드(S06-05-03-03_01-process_yield_dataset)
  import numpy as np
  import pandas as pd

  np.random.seed(42)
  n_samples = 1200

  # 1. 입력 특성(Features) 생성
  batch_id = [f"LOT_{i+1:04d}" for i in range(n_samples)]
  raw_tensile_strength = np.random.normal(280, 15, n_samples).round(1)  # MPa
  raw_thickness = np.random.normal(2.0, 0.05, n_samples).round(3)       # mm
  press_pressure = np.random.uniform(130, 190, n_samples).round(1)      # ton
  die_temp = np.random.uniform(190, 250, n_samples).round(1)            # ℃
  cool_rate = np.random.uniform(12, 32, n_samples).round(1)             # ℃/s
  operator_shift = np.random.choice(["Day", "Evening", "Night"], size=n_samples, p=[0.4, 0.35, 0.25])

  # 2. 물리적 메커니즘을 반영한 수율(Yield Rate) 산출 함수
  # 최적 기준: 금형온도 220℃ 부근, 압력 165ton 부근, 냉각속도 20℃/s 부근
  temp_penalty = ((die_temp - 220) ** 2) * 0.015
  pressure_penalty = ((press_pressure - 165) ** 2) * 0.012
  cool_penalty = np.where(cool_rate > 28, (cool_rate - 28) * 1.2, 0)
  mat_penalty = np.where(raw_tensile_strength < 260, (260 - raw_tensile_strength) * 0.15, 0)
  noise = np.random.normal(0, 2.0, n_samples)

  base_yield = 96.5
  yield_rate = base_yield - (temp_penalty + pressure_penalty + cool_penalty + mat_penalty) + noise
  yield_rate = np.clip(yield_rate, 65.0, 99.5).round(1)

  # 3. 품질 합부 판정 (수율 90.0% 이상이면 Pass, 미만이면 Fail)
  quality_status = np.where(yield_rate >= 90.0, "Pass", "Fail")

  # 4. 데이터프레임 조립 및 저장
  df = pd.DataFrame({
      "batch_id": batch_id,
      "raw_tensile_strength": raw_tensile_strength,
      "raw_thickness": raw_thickness,
      "press_pressure": press_pressure,
      "die_temp": die_temp,
      "cool_rate": cool_rate,
      "operator_shift": operator_shift,
      "yield_rate": yield_rate,
      "quality_status": quality_status
  })

  df.to_csv("S06-05-03-03_01-process_yield_dataset.csv", index=False, encoding="utf-8-sig")
  print("실습용 데이터셋 생성이 완료되었습니다: S06-05-03-03_01-process_yield_dataset.csv (1200행)")
4. Orange 3 따라하기 실습 가이드
-
Orange 3 최신 버전의 좌측 툴박스 카테고리(
Data,Visualize,Model,Evaluate) 기준 단계별 조작법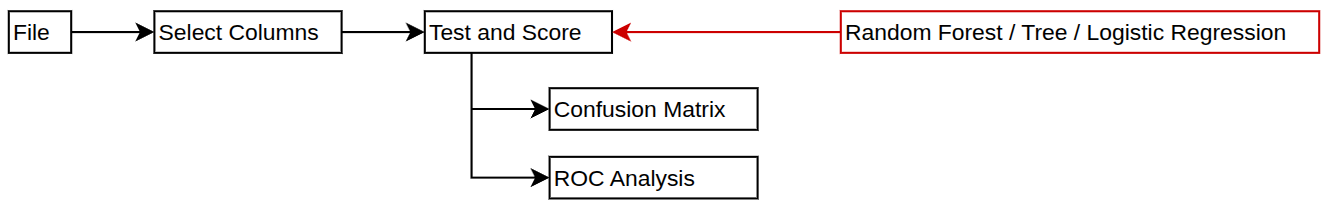 (Source: Sky Lectures / AiDALab)
- 1단계: 데이터 불러오기 및 역할(Role) 지정
- 좌측 패널의
Data탭에서File위젯을 캔버스로 드래그 File위젯을 더블클릭하고 폴더 아이콘을 눌러 생성한S06-05-03-03_01-process_yield_dataset.csv열기- 컬럼 목록의 속성(Role 및 Type)을 아래와 같이 설정
batch_id: Type = Text, Role = Meta (식별자이므로 학습에서 제외)raw_tensile_strength~cool_rate: Type = Numeric, Role = Featureoperator_shift: Type = Categorical, Role = Featureyield_rate: Type = Numeric, Role = Meta (1차 분류 실습 시에는 잠시 Meta로 둠)quality_status: Type = Categorical, Role = Target (예측할 타깃)
- 하단의 Apply 버튼을 클릭하여 적용
- 좌측 패널의
- 2단계: 데이터 탐색 및 분포 확인 (EDA)
- 좌측
Visualize탭에서Distributions위젯을 캔버스에 올려놓고,File위젯과 마우스 드래그로 선을 연결 Distributions위젯을 더블클릭- 좌측 변수에서
quality_status를 선택하여 Pass와 Fail의 비율(불균형 상태)을 확인 -
die_temp를 선택하고 하단 Columns 그룹의 Split by 항목을quality_status로 지정하면,
🡪 온도가 220℃에서 벗어날수록 Fail(불량) 영역이 급증하는 것을 시각적으로 확인할 수 있음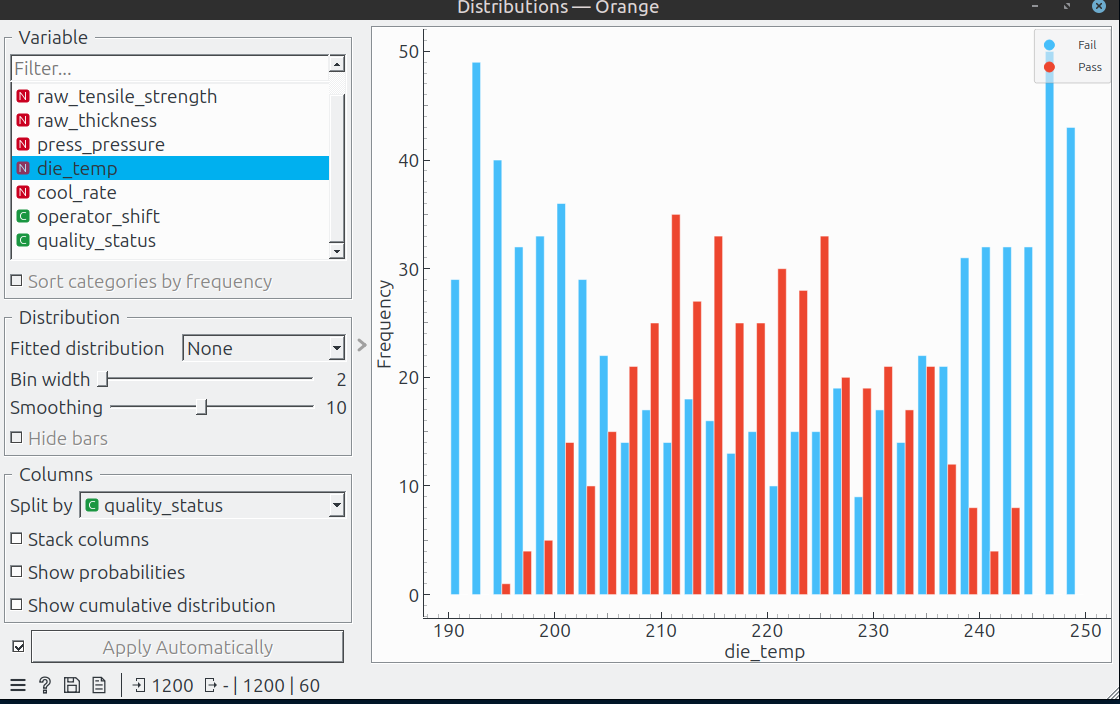 (Source: Sky Lectures / AiDALab)
- 그래프의 실제 분포 형태
- X축(금형 온도,
die_temp): 190℃ ~ 250℃ 범위 - 파란색 막대 (Fail, 불량):
- 205℃ 미만(저온 구간):
- 파란색 막대가 30~50회 수준으로 압도적
- 빨간색(Pass)은 거의 0에 수렴
- 235℃ 초과(과열 구간):
- 파란색 막대가 30~45회 이상으로 치솟고
- 빨간색(Pass)은 급감
- 205℃ 미만(저온 구간):
- 빨간색 막대 (Pass, 양품):
- 210℃ ~ 230℃ (특히 220℃ 인근 중심 구간):
- 빨간색 막대가 25~35회 수준으로 가장 높게 집중되어 종 모양(정규분포 형태)을 형성
- 210℃ ~ 230℃ (특히 220℃ 인근 중심 구간):
- X축(금형 온도,
- 판정
- 215℃ ~ 225℃(가운데 구간)에도 파란색(Fail) 막대가 약 15~18개씩 일정하게 존재
- “220℃인데 왜 불량(파란색)이 여전히 나오지? 설명과 다른 것 아닌가?”
- 가운데 파란색이 나오는 이유 (다변수 공정의 특성):
- 온도가 최적 조건(220℃)에 있더라도,
- 압력(
press_pressure)이 부족하거나 급랭 속도(cool_rate)가 너무 빠르면 불량이 발생하기 때문
- 단순히 “220℃에서 벗어나면 불량 급증”이라고만 보지 말것
- 220℃ 중심부에서는 양품(빨강)의 비율이 불량(파랑)을 압도하지만,
- 205℃ 이하 또는 235℃ 이상으로 벗어나는 순간 양품(빨강)은 전멸하고 불량(파랑)만 100% 남게 됨
- 가운데 구간의 일부 불량은
- 온도 외에 ‘압력’이나 ‘냉각속도’ 등 다른 공정 요인이 함께 작용했음을 시사
- 220℃ 중심부에서는 양품(빨강)의 비율이 불량(파랑)을 압도하지만,
- 215℃ ~ 225℃(가운데 구간)에도 파란색(Fail) 막대가 약 15~18개씩 일정하게 존재
- 정리
- 우측 범례에서 파란색은 Fail(불량), 빨간색은 Pass(양품)를 나타냄
- 적정 온도(215~225℃) 구간:
- 빨간색(Pass) 비율이 가장 높게 형성됨
- 가운데에 섞여 있는 파란색 막대는 압력·냉각속도 등 다른 변수에 의해 발생한 불량
- 저온(205℃ 미만) 및 과열(235℃ 초과) 구간:
- 빨간색(양품)이 급격히 사라지고 파란색(불량) 막대만 압도적으로 치솟는 패턴을 시각적으로 확인할 수 있음
- 이를 통해 “금형 온도가 220℃를 크게 벗어날수록 불량이 급증한다”는 공정 규칙을 직관적으로 검증할 수 있음
Pass와 Fail 그래프가 서로 주도하는 영역이 교차하는 지점(우열이 역전되는 지점)이라고 생각하면 이해하기 편함
- 그래프의 실제 분포 형태
- 좌측 변수에서
- 좌측
- 3단계: 불량 유무 분류 모델 구축 (Classification)
- 좌측
Evaluate탭에서Test and Score위젯을 캔버스에 배치하고,File위젯의 연결선을Test and Score에 연결 Test and Score를 더블클릭하여 평가 방식을 설정- Sampling type:
Cross validation(교차 검증) - Number of folds:
5(현업 권장 기본값)
- Sampling type:
- 좌측
Model탭에서 아래 3개 모델 위젯을 꺼내어 각각Test and Score에 선으로 연결Tree(의사결정나무):- 연결 방향: Tree (우측 출력점) 🡪 Test and Score (좌측 입력점)
- 신호 관계: 출발: Learner 🡪 도착: Learner
Random Forest(랜덤 포레스트):- 연결 방향: Random Forest (우측 출력점) 🡪 Test and Score (좌측 입력점)
- 신호 관계: 출발: Learner 🡪 도착: Learner
Logistic Regression(로지스틱 회귀):- 연결 방향: Logistic Regression (우측 출력점) 🡪 Test and Score (좌측 입력점)
- 신호 관계: 출발: Learner 🡪 도착: Learner
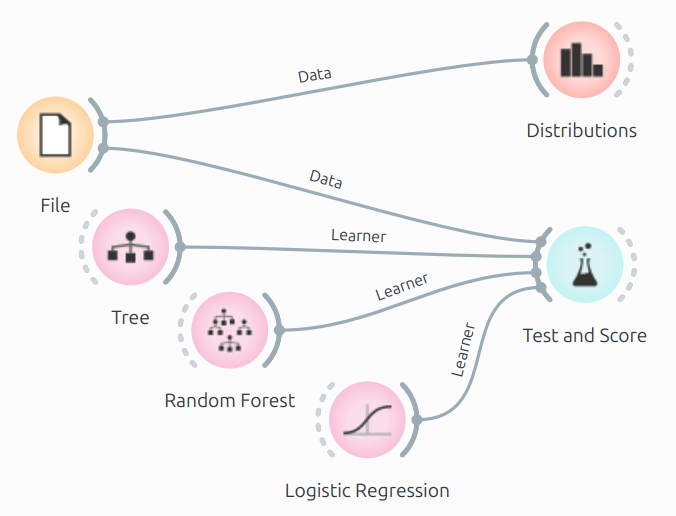 (Source: Sky Lectures / AiDALab)
- 선이 연결되는 즉시 5-Fold 교차 검증이 백그라운드에서 자동 연산됨
- 좌측
- 4단계: 모델 성능 평가 및 해석
-
Test and Score위젯을 더블클릭하여 평가표 확인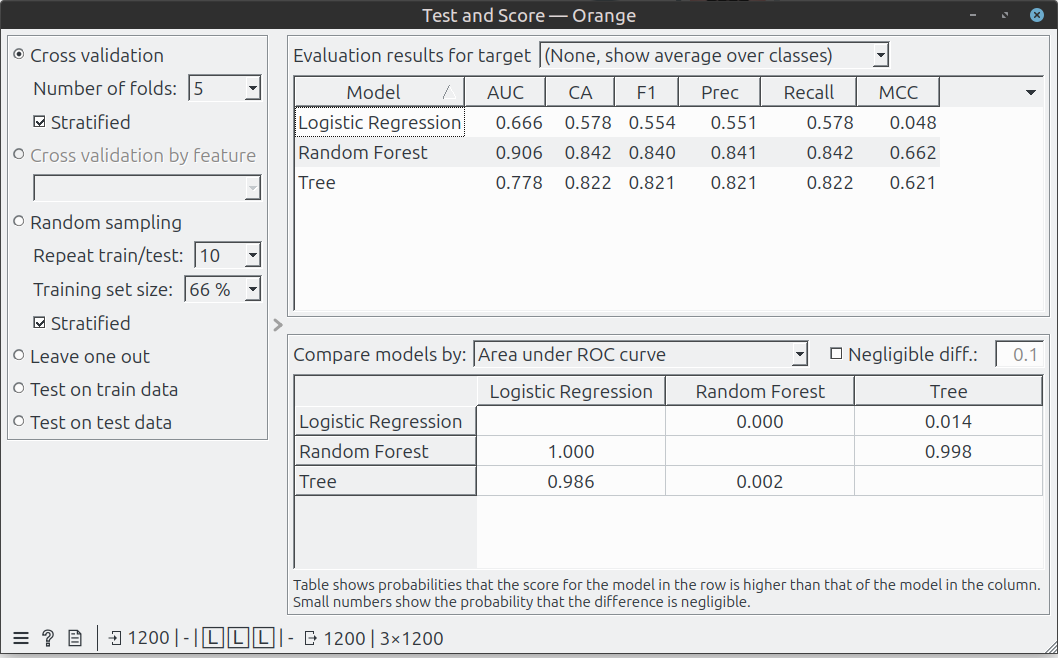 (Source: Sky Lectures / AiDALab)
- Target Class: 상단 드롭다운에서
Fail선택- 제조업에서는 불량을 놓치지 않는 것이 핵심이므로
Fail기준 평가지표가 필수
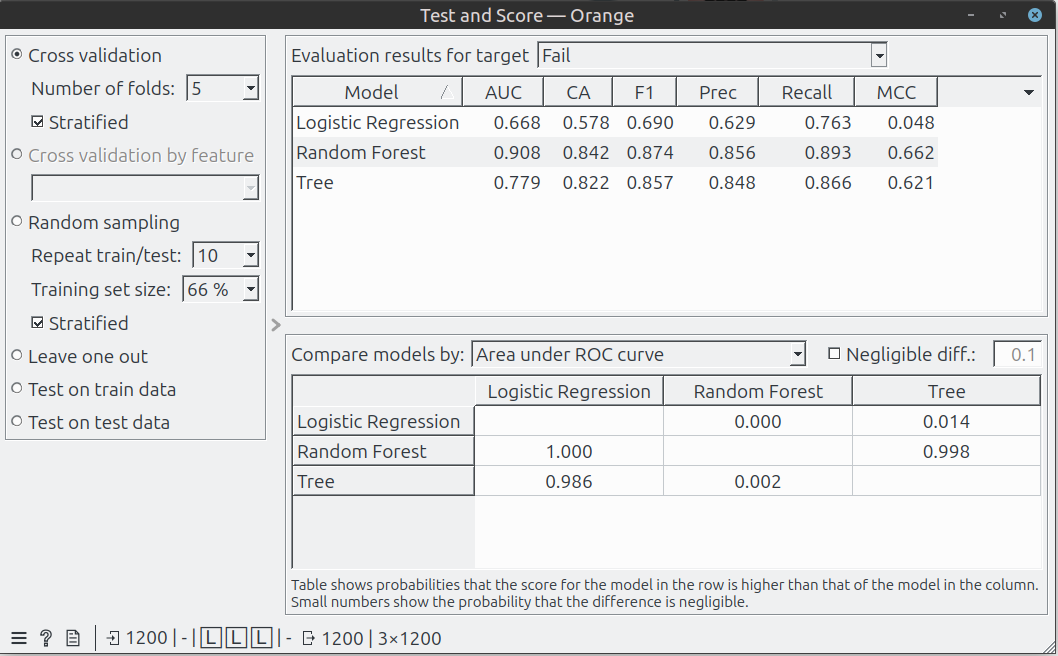 (Source: Sky Lectures / AiDALab)
- 제조업에서는 불량을 놓치지 않는 것이 핵심이므로
- 세부 지표별 상세 해석 (제조 현장 관점)
- Recall(재현율: 0.893 = 89.3%): 현업 최우선 지표
- 수식의 의미: 실제 발생한 불량 중 모델이 불량이라고 정확히 찾아낸 비율 🡪 이 수치가 0.85(85%) 이상인지 확인
- 현장에서의 의미:
- 공장에서 불량이 100개 발생했을 때,
- Random Forest 모델은 약 89개를 사전에 잡아내고, 11개만 놓친다(미검)는 뜻
- 실습 가이드라인의 합격 기준선(0.85 이상)을 0.893으로 여유 있게 통과했음
- 반면 Logistic Regression은 76.3%로, 불량 100개 중 24개나 놓쳐 현장 적용 시 위험함
- 공장에서 불량이 100개 발생했을 때,
- Precision (정밀도: 0.856 = 85.6%)
- 수식의 의미: 모델이 “이거 불량이다”라고 경고한 것 중 실제로 진짜 불량이었던 비율
- 현장에서의 의미:
- 모델이 작업자에게 “불량 위험 경고”를 100번 울렸을 때,
- 실제 86번은 진짜 불량이고, 14번만 멀쩡한 제품을 오판(과검/오경보)했다는 뜻
- 정밀도가 너무 낮으면 작업자에게 ‘알람 피로증(Alarm Fatigue)’을 유발하는데,
- 85.6% 수준이면 오경보가 적어 현장 신뢰도가 매우 높음
- 모델이 작업자에게 “불량 위험 경고”를 100번 울렸을 때,
- AUC (ROC 곡선 아래 면적: 0.908)
- 수식의 의미: 모델이 ‘정상’과 ‘불량’을 갈라내는 순수한 판별력 점수 (1.0 만점)
- 평가 기준:
- 0.90 이상: 매우 뛰어남(Excellent)
- 0.80 ~ 0.90: 양호(Good)
- 0.70 미만: 실무 적용 부적합(Poor)
- 평가 기준:
- 현장에서의 의미:
- Random Forest의 AUC가 0.908로 0.9를 넘었으므로,
- 단순 우연이 아니라 공정 변수(온도, 압력 등)와 불량 간의 관계를 모델이 매우 정교하게 파악하고 있음을 증명함
- Random Forest의 AUC가 0.908로 0.9를 넘었으므로,
- 수식의 의미: 모델이 ‘정상’과 ‘불량’을 갈라내는 순수한 판별력 점수 (1.0 만점)
- MCC (Matthews Correlation Coefficient: 0.662)
- 수식의 의미: 정상/불량 비율이 치우쳐 있는 불균형 데이터에서 모델의 전반적 신뢰도를 평가하는 상관계수 (-1 ~ +1)
- 현장에서의 의미:
- Logistic Regression의 MCC는 0.048로 사실상 동전 던지기(0에 수렴) 수준인 반면,
- Random Forest는 0.662로 매우 탄탄한 상관관계를 보임
- Recall(재현율: 0.893 = 89.3%): 현업 최우선 지표
- 하단 모델 비교표(Compare models by: Area under ROC curve) 해석
- 하단 표는 “행(Row)에 있는 모델이 열(Column)에 있는 모델보다 우수할 통계적 확률”을 나타냄
- Random Forest 행 확인:
- vs Logistic Regression: 1.000 (100% 확률로 더 우수함)
- vs Tree: 0.998 (99.8% 확률로 더 우수함)
- 결론: 통계적으로도 Random Forest가 단일 Tree나 Logistic Regression보다 불량 판별 성능에서 압도적으로 우세함이 입증
- 왜 ‘선형 회귀(Logistic)’는 실패하고 ‘트리 계열’이 성공했는가?
- 머신러닝의 특성을 확인하기에 좋은 결과
- Logistic Regression의 부진 (AUC 0.668, Recall 0.763):
- 로지스틱 회귀는 직선(선형)으로만 판단함 (“온도가 올라갈수록 불량이 무조건 는다/준다”)
- 실제 공정은 “온도가 너무 낮아도 불량(미성형), 너무 높아도 불량(크랙)”이라는 U자형(비선형) 2차 곡선 관계
- 직선을 긋는 모델은 이 양쪽 끝의 불량을 동시에 잡아내지 못함
- Random Forest의 성공 (AUC 0.908, Recall 0.893):
- 수많은 의사결정나무들이 “205℃ 미만이면 불량!”, “235℃ 초과여도 불량!”처럼 구간별로 영역을 쪼개어 판단함
- 공정의 비선형 물리 법칙을 정확하게 학습해 낸 것으로 볼 수 있음
- 수많은 의사결정나무들이 “205℃ 미만이면 불량!”, “235℃ 초과여도 불량!”처럼 구간별로 영역을 쪼개어 판단함
- 정리
- 최종 채택 모델: Random Forest
- 선정 사유:
- 제조 현장의 핵심 지표인 불량 재현율(Recall)이 89.3%로 기준치(85%)를 만족하여 미검 손실을 최소화함
- AUC 0.908, 정밀도(Precision) 85.6%로 불필요한 현장 오경보 없이 고신뢰도 사전 예측이 가능함
- 따라서 후속 실습인 Confusion Matrix 정밀 오차 분석과 Predictions 현장 적용 위젯에는 Random Forest 모델을 주력 엔진으로 채택함
- Target Class: 상단 드롭다운에서
-
좌측
Evaluate탭에서Confusion Matrix위젯을 꺼내Test and Score와 연결- 더블클릭하여 오차 행렬 열기
-
실제
Fail인데 모델이Pass로 오판한 미검(False Negative) 건수가 가장 적은 모델이 무엇인지 비교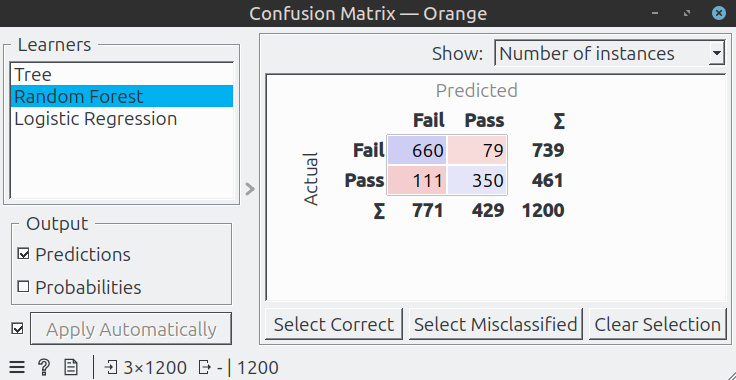 (Source: Sky Lectures / AiDALab)
Random Forest오차 행렬 4개 셀 수치 분석- 가로축 (Predicted): 모델이 예측한 결과
-
세로축 (Actual): 실제 공정에서 발생한 결과
- [660건] 정탐 (True Positive: 불량을 정확히 잡아냄)
- 실제 발생한 불량 739건 중 660건을 모델이 사전에 정확히 적발
- 재현율(Recall): $\frac{660}{739} \approx \mathbf{89.3\%}$ (앞선
Test and Score의Recall = 0.893과 정확히 일치)
- [79건] 미검 ★ 핵심 개선 지표 (False Negative: 불량인데 정상으로 방출)
- 실제 불량인데 모델이 ‘Pass(정상)’로 오판하여 고객사로 유출될 뻔한 위험 수량
Tree모델의 99건에서 79건으로 20건(약 20.2%)이나 감소함- 현장 의미: 수백 개의 나무 모델이 앙상블(다수결)로 판단하면서 단일 트리보다 불량 감지 그물망이 훨씬 촘촘해졌음을 보여줌
- [111건] 과검 (False Positive: 정상인데 불량으로 오경보)
- 실제로는 정상(양품)인데 모델이 ‘Fail(불량)’로 경고한 수량
Tree모델(115건) 대비 4건 줄어듦 🡪 현장 작업자가 겪는 ‘불필요한 재확인/알람 피로’도 함께 개선됨- 정밀도(Precision): $\frac{660}{660 + 111} = \frac{660}{771} \approx \mathbf{85.6\%}$
Test and Score의Prec = 0.856과 정확히 일치
- [350건] 진음성 (True Negative: 정상을 정상으로 통과시킴)
- 전체 정상품 461건 중 350건을 안전하게 정상으로 판정함
-
TreevsRandom Forest직접 대조 요약구분 Tree (단일 의사결정나무) Random Forest (랜덤 포레스트) 현장 개선 효과 불량 적발 (TP) 640건 660건 +20건 추가 적발 (적발력 향상) 불량 누출 (FN, 미검) ★ 99건 79건 -20건 감소 (클레임/리콜 리스크 대폭 축소) 오경보 (FP, 과검) 115건 111건 -4건 감소 (현장 작업 피로도 개선) 전체 맞힌 개수 (정확도) 986건 (82.2%) 1,010건 (84.2%) 전체적인 예측 신뢰도 동반 상승
- 결론 가이드
- “왜 우리는 단일 트리가 아니라 Random Forest를 최종 양산 모델로 선택해야 하는가?”
- 오차 행렬에서 가장 주의 깊게 보아야 할 곳은 우측 상단의 ‘미검(False Negative, 79건)’
Tree모델에 비해 불량 유출을 99건에서 79건으로 즉시 20건이나 줄여주기 때문에, 사업재편 초기 수율 안정화와 고객사 클레임 방지에 가장 안전한 선택- 따라서 최종 현장 알람 시스템 및 조업 파라미터 제어에는
Random Forest모델을 탑재하는 것으로 결론을 내릴 수 있음
- “왜 우리는 단일 트리가 아니라 Random Forest를 최종 양산 모델로 선택해야 하는가?”
-
- 5단계: 공정 룰 도출 및 시각화 (해석 가능한 AI)
-
Model탭의Tree위젯 바로 옆에Visualize탭의Tree Viewer위젯을 연결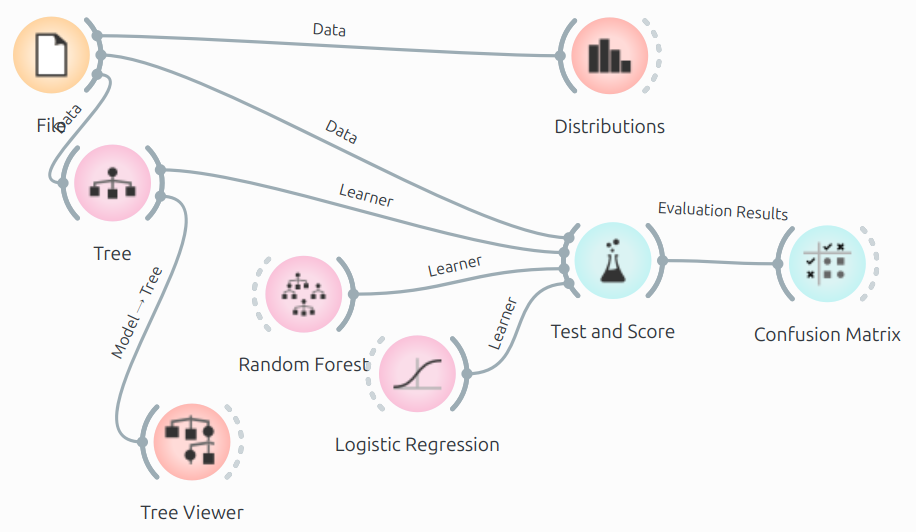 (Source: Sky Lectures / AiDALab)
-
Tree Viewer를 더블클릭하면 시각적 분기 다이어그램이 펼쳐짐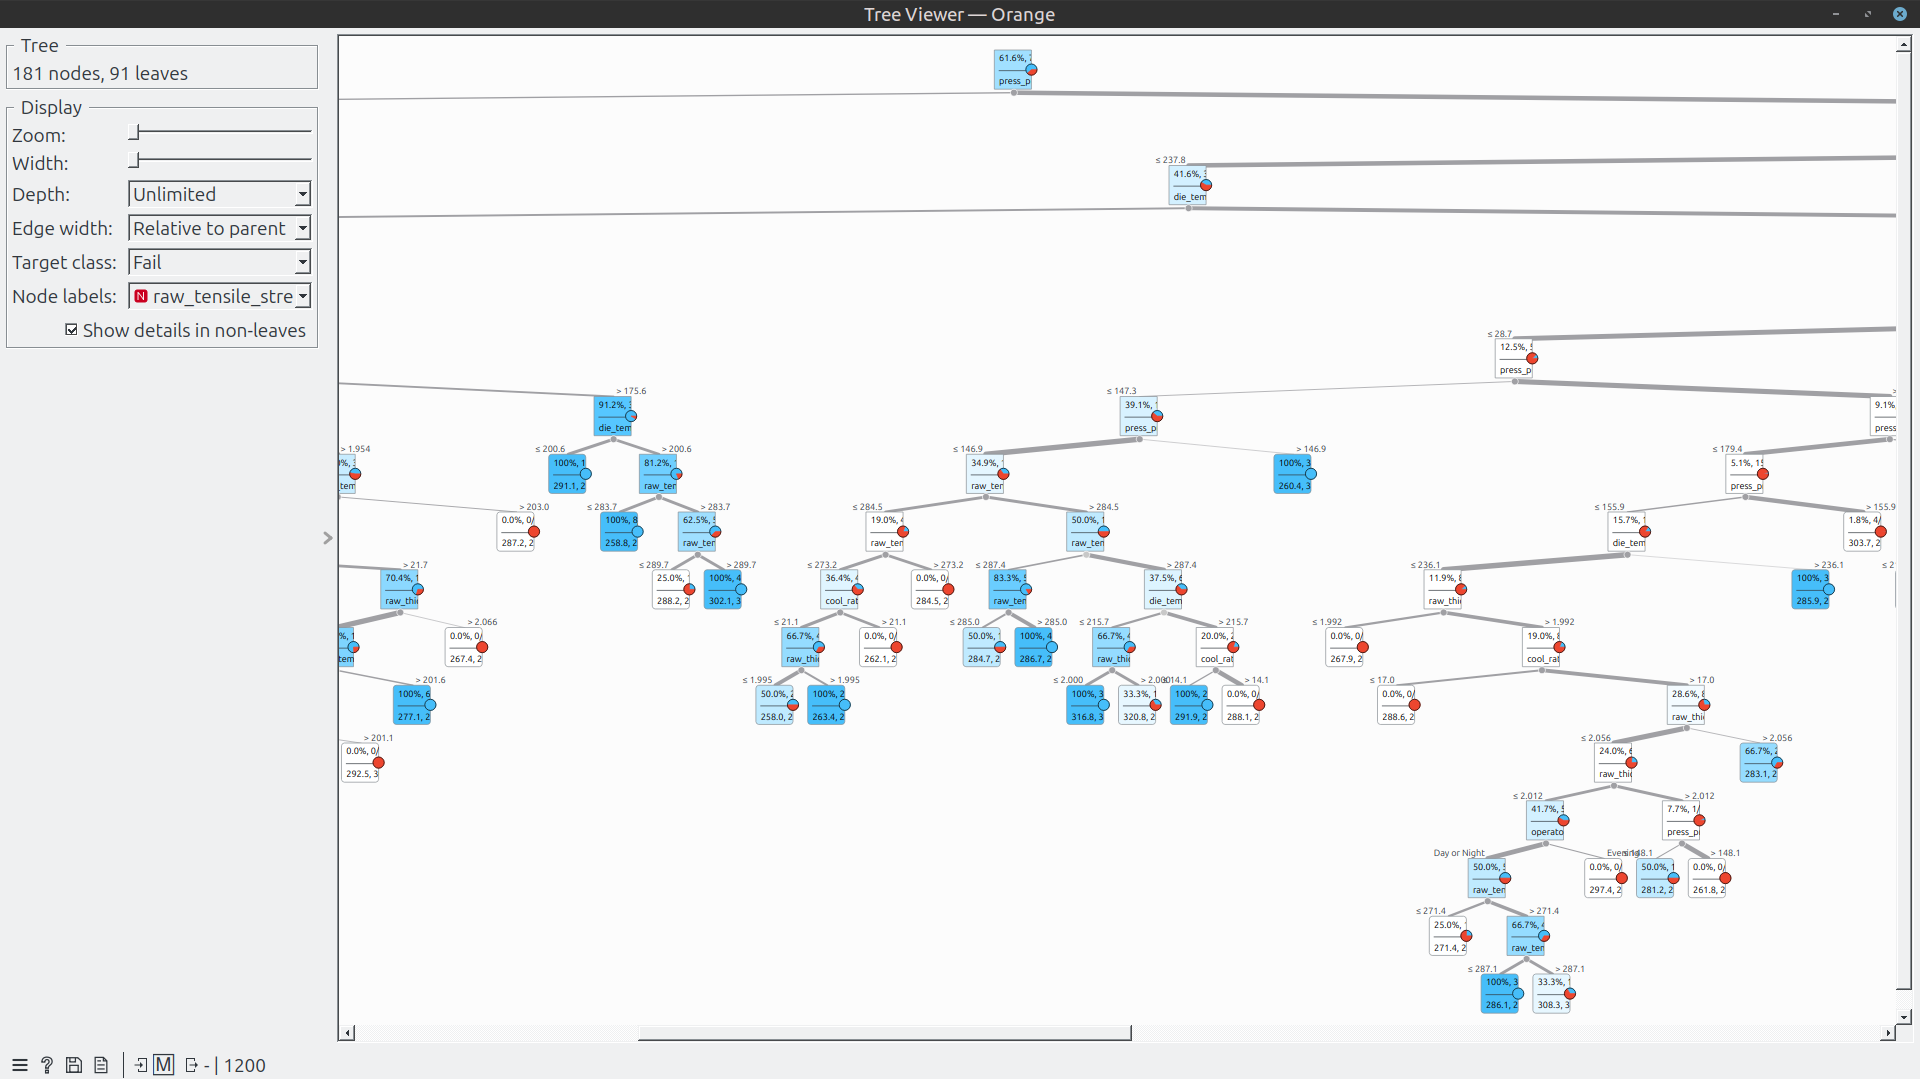 (Source: Sky Lectures / AiDALab)
- 최상단 첫 번째 분기 조건이 무엇인지 확인 (예:
die_temp <= 204.5또는press_pressure <= 148.2). - 실무 해석:
- 현장 작업자가 즉시 알 수 있는 “금형 온도가 몇 도 미만으로 떨어지면 불량률이 70% 이상으로 치솟는다”는
명확한 조업 룰(Rule-based) 가이드라인을 바로 추출할 수 있음
- 현장 작업자가 즉시 알 수 있는 “금형 온도가 몇 도 미만으로 떨어지면 불량률이 70% 이상으로 치솟는다”는
- 보고 싶은 항목을 기준으로 수정하면서 확인해 볼 것
- 최상단 첫 번째 분기 조건이 무엇인지 확인 (예:
-
5. 수율 예측 회귀 모델로의 확장
-
품질 상태(Pass/Fail)가 아니라 연속형 수율 수치(65% ~ 99%) 자체를 예측하고자 할 때의 전환 방법
Transform탭의Select Columns위젯을File위젯 뒤에 연결Select Columns를 열고:- Target 칸에 있던
quality_status를 좌측 Ignored로 내림 - Features/Meta에 있던
yield_rate를 Target 칸으로 드래그하여 올림
- Target 칸에 있던
Select Columns의 출력을 새로운Test and Score위젯에 연결-
Model탭에서Linear Regression과Random Forest를 연결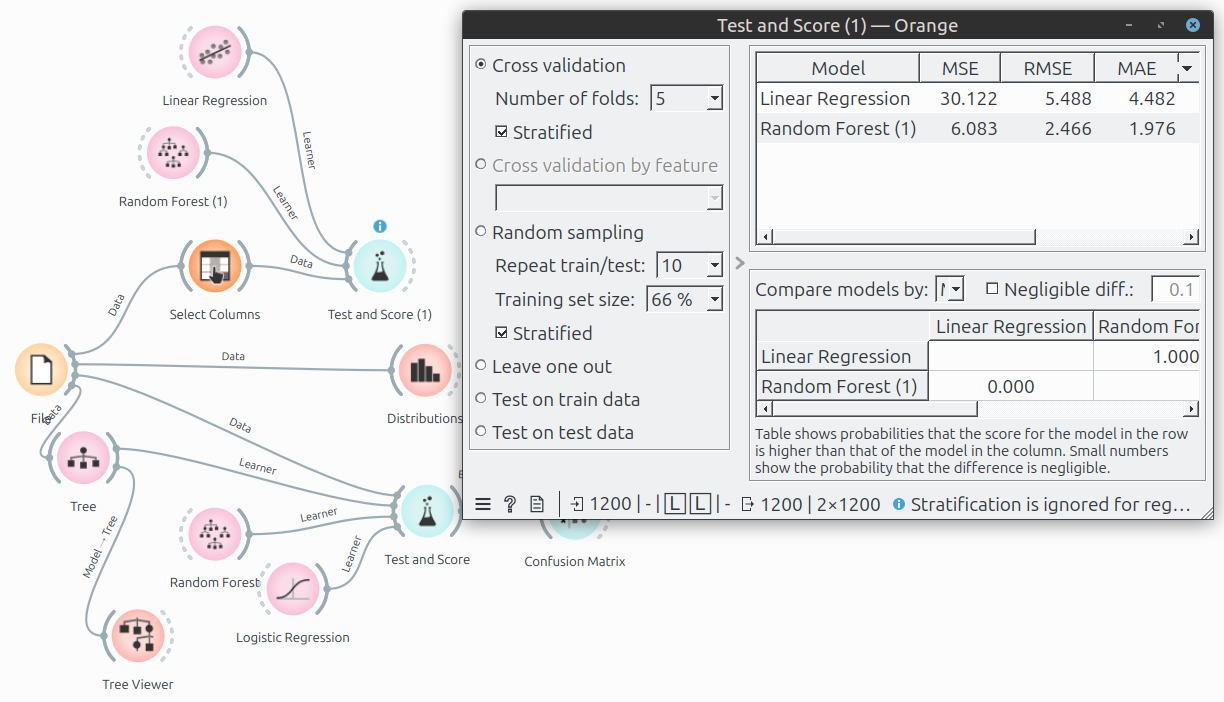 (Source: Sky Lectures / AiDALab)
Test and Score의 결과표가 분류 지표(AUC, F1)에서 회귀 지표(RMSE, $R^2$)로 자동 변경된 것을 확인- $R^2$ (결정계수):
- 1에 가까울수록 공정 변수들이 수율 변화를 완벽히 설명함을 의미함
- 0.85 이상이면 양호
- RMSE (평균 제곱근 오차):
- 모델의 수율 예측 오차 범위(%)를 나타냄
- 예: RMSE가 1.8이면 예측치와 실제 수율 차이가 평균 ±1.8%p 수준임을 의미
- $R^2$ (결정계수):
